实用文章
OpenAI 兼容 API 报错大全:400、401、404、429、超时怎么解决?
系统梳理 OpenAI 兼容 API 常见的 400、401、404、429、408、502、503、504、流式中断、模型列表为空和账单对不上问题。按现象、先查什么、怎么修、怎么验证修好的顺序,提供 curl、Python、Node.js 和 PowerShell 可复制示例,并说明 request_id、Retry-After、模型端点、工具 Schema 与 Anthropic 原生协议的排查方法。
API 报错通常不是随机故障:先看 HTTP 状态码,再看响应体里的 error code、message 和 request_id,最后用 curl 最小复现,往往几分钟就能判断是密钥、模型、请求参数、限流、余额还是上游问题。400、401、404 这类错误多数需要修改请求或配置,原样重试通常没有用;429、503 等暂时性错误才适合按 Retry-After 做有限次数的退避重试。
本文按“现象 → 先查什么 → 怎么修 → 怎么验证修好了”展开,覆盖 OpenAI 兼容接口和 Anthropic 原生 /v1/messages 接口。站内错误码与处置方式以错误码文档为准,通用 HTTP 含义则参考 OpenAI、Anthropic、Google、xAI 等官方文档;不同平台的具体模型、配额和账务规则仍应以实际响应和官方页面为准。
- 本文适用对象:第一次接触大模型 API 的开发者、正在接入第三方 API 的个人用户、使用 OpenAI SDK、Claude Code、Cursor 或其他可自定义接口地址的工具用户。
- 最后更新:2026-10-17
- 实测或资料环境:站内错误码、端点、流式和账单文档;OpenAI、Anthropic、Google、xAI、Cursor 官方开发者文档;示例命令适用于 macOS、Linux 与 Windows PowerShell。
30 秒定位表:先看状态码,再决定是否重试
大白话:错误码是“路标”,完整错误响应体才是“具体地址”。不要只复制客户端弹出的半句话,优先保存 HTTP 状态、响应头、JSON 响应体和 request_id。
| HTTP 状态码 | 常见 error code 或 error.type | 一句话原因 | 第一步做什么 | 重试有没有用 |
|---|---|---|---|---|
| 400 | invalid_request_error、upstream_rejected_request、context_length_exceeded、system_not_supported_upstream | 请求格式、参数、工具 Schema、输入长度或模型能力不匹配 | 读取 message,删除不支持的字段,修正载荷或缩短输入 | 原样重试通常没有用 |
| 401 | invalid_api_key、authentication_error | 密钥无效、未生效、被吊销,或来源 IP 不在白名单 | 检查环境变量、Authorization 或 x-api-key 写法和来源 IP | 无效密钥重试没有用 |
| 403 | permission_error | 套餐、密钥范围、内容策略或账号状态不允许 | 看 message 判断是模型权限、内容策略还是账号状态 | 权限没变时没有用 |
| 404 | model_not_found、not_found_error | 模型名、端点路径或协议不匹配 | GET /v1/models,核对模型名、大小写和端点 |
模型不存在时没有用 |
| 408 | 请求超时 | 客户端或网关在规定时间内没有完成请求 | 区分客户端超时、服务端超时和流式空闲超时 | 幂等请求可有限重试 |
| 413 | request_too_large | 请求体过大 | 拆分输入、压缩或减少多模态内容 | 原样重试没有用 |
| 429 | rate_limit_exceeded、rate_limit_error | 请求过快、配额用尽、余额不足或密钥预算到顶 | 先看余额和预算,再看 Retry-After 与 message | 只有明确是限流时才退避重试 |
| 502 | upstream_error、api_error | 上游返回错误或上游全部失败 | 换模型做对照,保存 request_id | 可有限重试,持续出现需报障 |
| 503 | overloaded_error、no_available_channel | 暂时没有可用上游或模型处于冷却、受限状态 | 读取 Retry-After,降低并发并稍后重试 | 通常可以退避重试 |
| 504 | api_error | 请求到达超时期限后被硬中止 | 检查客户端 timeout、输入规模和流式设置 | 可有限重试,但不能无限等待 |
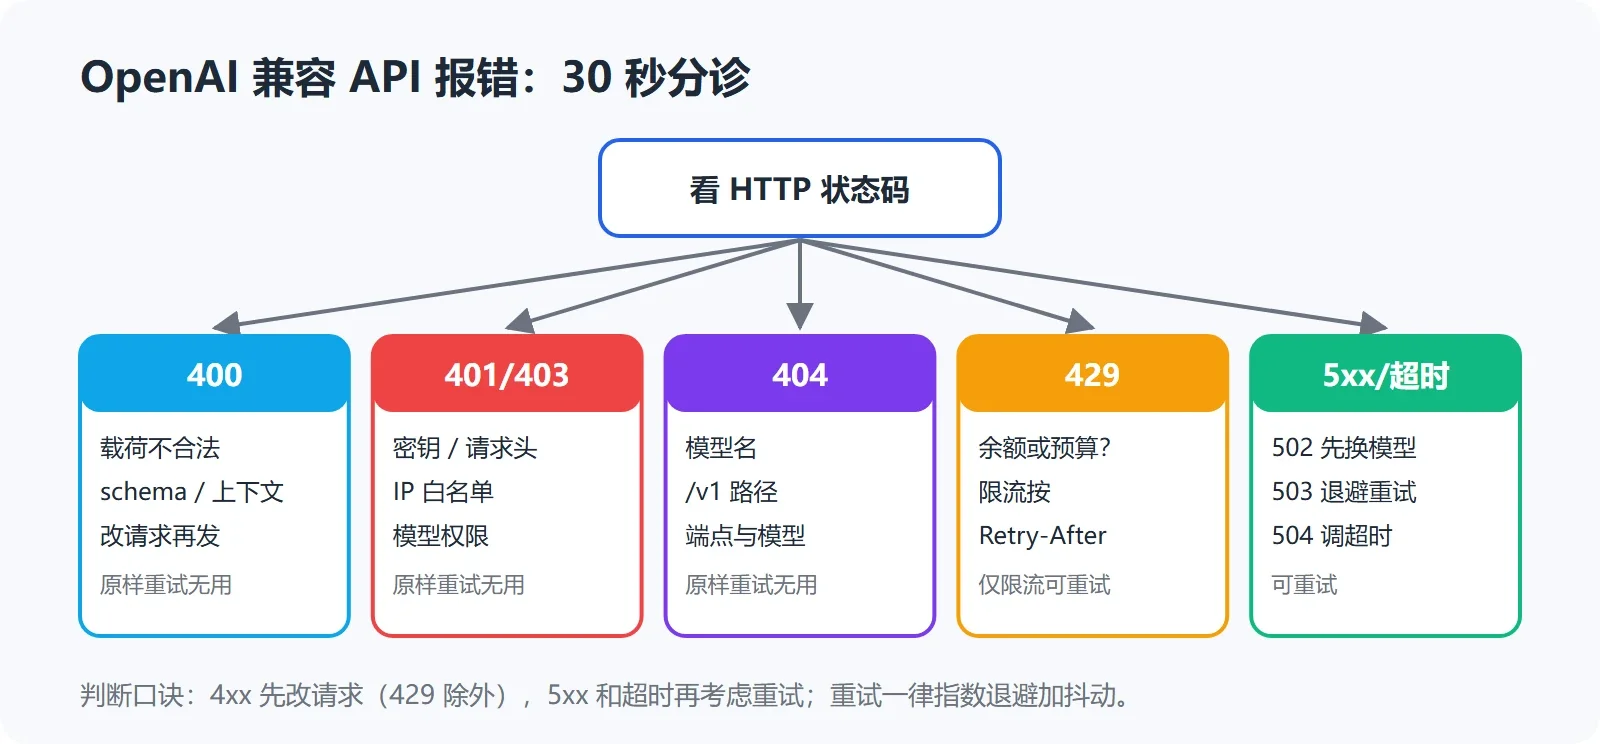
OpenAI 兼容 API 报错 30 秒分诊
排查前先做的 3 件事
大白话:先把“猜测”变成“证据”。如果只在 SDK 的异常字符串里来回看,容易把地址、密钥、模型、代理和客户端缓存混在一起。
- 拿到完整错误响应体。记录 HTTP 状态码、响应头、JSON body,尤其是 error、message、type、code、request_id 和 Retry-After。某些客户端默认只显示 message,完整 body 可能被隐藏。
- 记下 request_id。每一笔响应都尽量保留 request_id。控制台的请求日志可以按 request_id 查单笔调用;没有 request_id,报障时只能靠时间和模型猜测,定位效率会明显下降。
- 用 curl 做最小复现。先跳过 SDK、代理封装、桌面客户端和业务代码,只保留 URL、鉴权头、模型、一个最短消息。这样可以确认问题究竟在接口本身,还是在客户端组装请求的过程。
OpenAI 兼容接口的接入地址为 https://api.xisu.ai/v1,常用对话端点是 POST /v1/chat/completions,模型列表端点是 GET /v1/models。端点和鉴权的完整说明见 端点与鉴权,从零配置可以先看 5 分钟接入。
curl -i -v https://api.xisu.ai/v1/chat/completions \
  -H "Authorization: Bearer $XISU_API_KEY" \
  -H "Content-Type: application/json" \
  -d '{
    "model": "你的模型名",
    "messages": [{"role": "user", "content": "只回复 OK"}],
    "max_tokens": 16
  }'
macOS/Linux 使用上面的写法;Windows PowerShell 可运行:
curl.exe -i -v https://api.xisu.ai/v1/chat/completions `
  -H "Authorization: Bearer $env:XISU_API_KEY" `
  -H "Content-Type: application/json" `
  --data-raw '{
    "model": "你的模型名",
    "messages": [{"role": "user", "content": "只回复 OK"}],
    "max_tokens": 16
  }'
-i 会显示响应头,-v 会显示请求连接过程。成功时通常能看到 2xx 状态和 JSON 回复;失败时不要只看最后一行,重点看状态、error.code 或 Anthropic 协议里的 error.type,以及响应头中的 request_id 和 Retry-After。
401 Unauthorized / invalid_api_key:先查密钥和鉴权头
大白话:401 的意思不是“模型回答失败”,而是服务器没有接受这次身份认证。最常见原因是 Key 复制不完整、前后有空格或换行、环境变量没有进入当前终端、Authorization 头少了 Bearer,或者密钥已被吊销。
先查什么
- 确认密钥完整,不能把控制台显示的前缀、后缀或中间字符漏掉,也不要把换行一起复制进去。
- OpenAI 兼容接口使用
Authorization: Bearer sk-xxxx,Bearer 后面必须有空格。 - Anthropic 原生接口使用
x-api-key: sk-xxxx,不要把它误写成只有 Authorization 的形式;同时按 Anthropic 原生端点要求发送版本头。 - 确认调用进程真的读取到了环境变量。新开终端后再运行,尤其是 Windows 设置用户环境变量后,已经打开的 PowerShell 不会自动刷新。
- 如果密钥配置过 IP 白名单,从名单外的来源调用也可能返回 401 invalid_api_key。先确认来源 IP,再考虑重建密钥。
- 检查密钥是否被吊销。若同一个 Key 在多个项目中都 401,优先检查控制台状态,而不是不断重试。
不要直接打印完整密钥。只打印长度或前四位即可:
# macOS/Linux:只打印长度和前 4 位
python3 - <<'PY'
import os
key = os.getenv("XISU_API_KEY", "")
print("length:", len(key))
print("prefix:", key[:4] if key else "<empty>")
PY

# Windows PowerShell:只打印长度和前 4 位
$key = $env:XISU_API_KEY
if ($null -eq $key) { $key = "" }
Write-Output ("length: " + $key.Length)
Write-Output ("prefix: " + $(if ($key.Length -ge 4) { $key.Substring(0,4) } else { "<empty>" }))
如果长度为 0,说明当前进程没有拿到变量;如果前四位不是你预期的密钥前缀,说明变量可能被旧值覆盖。修正后要重新运行最小 curl 命令,不要先回到复杂 SDK。
怎么验证修好了
使用同一终端先请求模型列表。如果 GET /v1/models 能返回 JSON,说明基础鉴权和地址大概率已经打通;之后再用一个最短 chat 请求验证模型和载荷。若仍然 401,记录 request_id、来源 IP、调用时间和完整错误体,到控制台日志核对。
400 Invalid schema、upstream_rejected_request:工具参数要先过 Schema 检查
大白话:工具调用不是把一段 JSON 随便塞进请求,而是要告诉模型“工具参数是什么类型、哪些字段必填、是否允许额外字段”。Schema 的结构不一致,常见结果就是 400 Invalid schema for function 或站内的 upstream_rejected_request。
最常见的错误
以下示例把 required 写成了不存在的字段,同时遗漏了对象的 type,并在严格校验场景下没有明确处理额外属性:
{
  "type": "function",
  "function": {
    "name": "get_weather",
    "parameters": {
      "properties": {
        "city": {"type": "string"}
      },
      "required": ["location"]
    }
  }
}
修正时要让 required 中的每个名字都存在于 properties,并明确根对象是 object。如果目标模型或上游要求严格 Schema,还要按其规则处理 additionalProperties、必填字段和 strict 模式:
{
  "type": "function",
  "function": {
    "name": "get_weather",
    "description": "查询指定城市天气",
    "strict": true,
    "parameters": {
      "type": "object",
      "properties": {
        "city": {
          "type": "string",
          "description": "城市名称"
        }
      },
      "required": ["city"],
      "additionalProperties": false
    }
  }
}
注意:不同协议、模型和上游对 Schema 子集的支持可能不同。MCP 工具转换到 function tool 时,尤其要检查嵌套对象、数组 item、required 与 properties 是否一致。遇到站内 upstream_rejected_request 时,message 通常包含上游原话,应按原话修改载荷;原样重试会得到同类错误。可以继续参考 工具的参数 schema 被拒。
另外两个常见的 400
context_length_exceeded:输入长度超过该模型在平台声明的上下文上限。缩短历史消息、减少工具说明、拆分长文档,或改用上下文更大的模型。报错如果带实际长度和上限,应以这两个数字为准。
system_not_supported_upstream:该模型当前上游会丢弃 system 提示词。按站内处置方式,去掉 system 后重试,或在模型广场选择没有“不支持 system”标记的模型。它不是密钥问题,也不是靠重试解决的问题。
内容被平台策略拦下时,站内可能返回 content_policy_violation;原样重试通常没有用,需要修改内容。请求中包含平台无法读取的预分词 token 数组、图片或 PDF 等内容时,可能出现 content_policy_needs_text,应改发可读取的文本或联系平台确认支持方式。
404 model not found:模型、端点和协议要对上
大白话:404 不一定是模型真的下架,也可能是模型名拼错、大小写不一致、地址多了或少了 /v1,或者把不支持 Anthropic 协议的模型发到了 /v1/messages。
先查什么
- 直接请求
GET /v1/models,复制返回结果中的模型 id,不要凭记忆手写。 - 核对大小写、连字符、版本后缀和完整模型名。模型名看起来相近,不代表是同一个 id。
- OpenAI 兼容客户端的 base_url 通常填写
https://api.xisu.ai/v1。如果客户端会自动追加/v1,就要避免形成/v1/v1。 - Claude Code 的
ANTHROPIC_BASE_URL不带/v1,应填写https://api.xisu.ai,由客户端请求/v1/messages。 - 检查端点路径。OpenAI 兼容对话通常走
/v1/chat/completions;Anthropic 原生请求走/v1/messages。 - 非 Claude 模型走
/v1/messages可能返回 Anthropic 的not_found_error。站内说明是换一个支持 Anthropic 上游的模型,或改走/v1/chat/completions。
# macOS/Linux:列出模型并筛选 id
curl -sS https://api.xisu.ai/v1/models \
  -H "Authorization: Bearer $XISU_API_KEY" | jq -r '.data[]?.id'

# Windows PowerShell:列出模型并筛选 id
$headers = @{ Authorization = "Bearer $env:XISU_API_KEY" }
(Invoke-RestMethod -Uri "https://api.xisu.ai/v1/models" -Headers $headers).data | Select-Object -ExpandProperty id
如果命令本身返回 401,先回到密钥排查;如果返回模型数组但没有目标模型,重点查密钥模型范围和模型是否在售;如果模型列表正常而 chat 404,重点查端点拼接和请求协议。端点清单见 端点与鉴权,模型范围和可用性以 模型与选型以及 GET /v1/models 为准。
429 Too Many Requests:先区分限流、余额和预算
大白话:429 只说明服务器暂时没有按当前条件接受请求,不等于一种固定原因。站内 OpenAI 兼容错误码中,rate_limit_exceeded 表示请求过快;但 insufficient_balance、account_overdrawn、budget_exceeded 也需要分别处理。Anthropic 原生协议下,余额不足、配额用尽、密钥预算到顶和限流共用 429 rate_limit_error,必须阅读 message 并查看余额。
先查什么
- 读取响应头中的 Retry-After,单位通常是秒;如果服务端给了它,优先尊重这个值。
- 查看 message 是否明确写的是账务限制、密钥预算、配额还是请求频率。
- 到控制台确认余额、密钥预算和近期调用量。余额不足时重试没有意义;account_overdrawn 表示余额为负,站内说明通常与退款扣回有关,单纯充值不一定能解决根因。
- 如果确定是请求过快,降低并发、控制每秒请求数和 token 量,再做指数退避加抖动。
固定每隔一秒重试的问题是:多个请求会在同一时间再次撞上限流,形成同步重试。指数退避让等待时间逐步增加,抖动则避免大量客户端同时醒来。上限可以取 Retry-After 与本地超时策略中更大的那个,但仍要设置最大尝试次数。
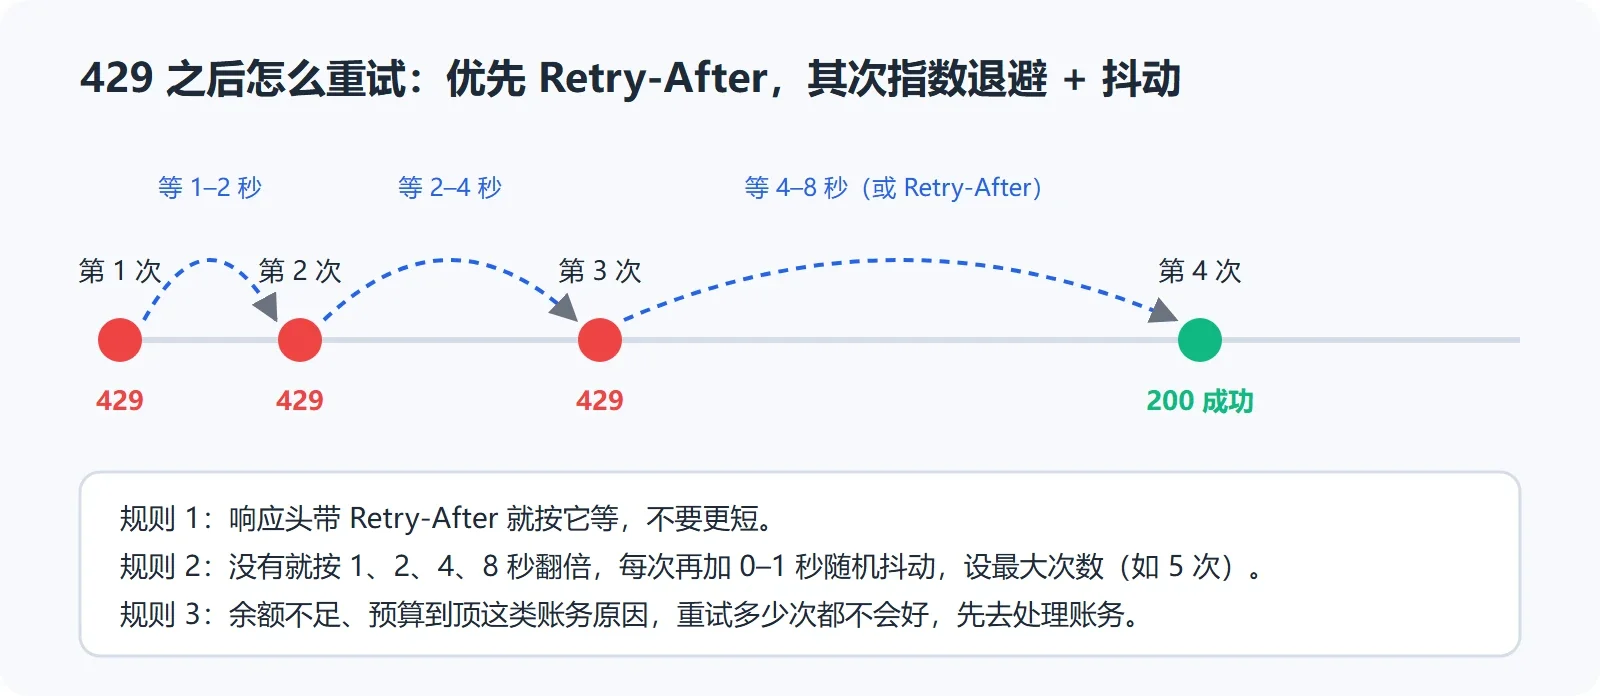
429 之后的重试节奏:Retry-After 优先,其次指数退避加抖动
import os
import random
import time
import requests

URL = "https://api.xisu.ai/v1/chat/completions"
HEADERS = {
    "Authorization": f"Bearer {os.environ['XISU_API_KEY']}",
    "Content-Type": "application/json",
}
PAYLOAD = {
    "model": "你的模型名",
    "messages": [{"role": "user", "content": "只回复 OK"}],
    "max_tokens": 16,
}

for attempt in range(6):
    response = requests.post(URL, headers=HEADERS, json=PAYLOAD, timeout=60)
    if response.status_code not in (429, 502, 503, 504):
        print(response.status_code, response.text)
        response.raise_for_status()
        break

    retry_after = response.headers.get("Retry-After")
    try:
        server_wait = float(retry_after) if retry_after else 0
    except ValueError:
        server_wait = 0

    body = response.text[:500]
    if response.status_code == 429 and any(word in body.lower() for word in ["balance", "budget", "overdrawn"]):
        raise RuntimeError(f"可能是账务限制,不继续重试:{body}")

    if attempt == 5:
        response.raise_for_status()

    exponential = min(60, 2 ** attempt)
    wait = max(server_wait, exponential) + random.uniform(0, 0.5)
    print(f"attempt={attempt + 1}, status={response.status_code}, wait={wait:.2f}s")
    time.sleep(wait)
输出中的 status=429 且等待时间逐步增加,说明重试逻辑生效;如果每次 message 都明确写余额、预算或账务限制,应停止重试并处理账号状态。
import OpenAI from "openai";

const client = new OpenAI({
  apiKey: process.env.XISU_API_KEY,
  baseURL: "https://api.xisu.ai/v1"
});

function sleep(ms) {
  return new Promise(resolve => setTimeout(resolve, ms));
}

async function callWithBackoff() {
  for (let attempt = 0; attempt < 6; attempt += 1) {
    try {
      return await client.chat.completions.create({
        model: "你的模型名",
        messages: [{ role: "user", content: "只回复 OK" }],
        max_tokens: 16
      });
    } catch (error) {
      const status = error.status;
      const retryAfterHeader = error.headers?.get?.("retry-after") ?? error.headers?.["retry-after"];
      const retryAfter = Number(retryAfterHeader || 0);
      const retryable = [408, 429, 502, 503, 504].includes(status);
      if (!retryable || attempt === 5) throw error;
      const exponential = Math.min(60000, 1000 * (2 ** attempt));
      const wait = Math.max(exponential, retryAfter * 1000) + Math.random() * 500;
      console.error(`status=${status}, retry in ${Math.round(wait)}ms`);
      await sleep(wait);
    }
  }
}

callWithBackoff().then(result => {
  console.log(result.choices?.[0]?.message?.content ?? result);
});
Node.js 示例只对明确的暂时性状态重试。生产环境还应根据响应体区分 rate_limit_exceeded 与账务限制;不要因为 SDK 抛出了同一个异常类,就把所有 429 都无限重试。
408、502、503、504 与 API 超时:先区分谁在等待
大白话:超时有三层:客户端在等多久、网关允许请求运行多久、上游多久没有产生可交付结果。把客户端 timeout 调得很大,不一定能改变服务端的硬截止时间;504 到点后请求已经结束,不能靠继续等待拿回同一条响应。
怎么判断
408:请求在客户端或服务端等待窗口内没有完成。先检查网络、输入规模、并发和 timeout 设置。
502 upstream_error:站内含义是上游返回了错误,原因不一定归到你的载荷上。可以先换一个模型做对照;如果某个模型持续失败,带 request_id 提交工单。
503 overloaded_error:Anthropic 原生协议下表示该模型此刻没有可用上游,属于暂时状态。按响应中的 Retry-After 退避;它和 404 not_found_error 的处理不同,404 是模型或协议不匹配,503 才是临时不可用。
504:请求到达截止时间后被硬中止。可以减少输入、降低输出上限、使用流式,或调整客户端超时;但如果每次都在服务端截止时间附近失败,就不能只把本地 timeout 无限调大。
OpenAI 官方错误文档建议把可重试错误与请求本身的错误分开处理;Google 官方故障排查文档也建议对 429 和 5xx 使用指数退避,并设置最大重试次数。具体状态码、响应头和上游行为仍以实际服务为准。
import os
from openai import OpenAI

client = OpenAI(
    api_key=os.environ["XISU_API_KEY"],
    base_url="https://api.xisu.ai/v1",
    timeout=60.0,
    max_retries=2,
)

response = client.chat.completions.create(
    model="你的模型名",
    messages=[{"role": "user", "content": "只回复 OK"}],
    max_tokens=16,
)
print(response.choices[0].message.content)
这段代码把单次客户端请求上限设为 60 秒,并允许 SDK 对其支持的暂时性错误做有限重试。验证时看是否能稳定返回内容;若仍然在相同耗时附近 504,记录 request_id、耗时和模型,继续按 上线前:超时、重试与工具调用检查。
流式输出中断:确认是正常结束还是连接断了
大白话:流式响应不是一次性 JSON,而是一串 SSE 事件。看到部分文字并不等于请求正常结束;要确认最后是否收到正常结束标记、finish_reason 或协议对应的终止事件。
OpenAI 兼容流式怎么判断
- OpenAI 兼容流式响应通常以
data: [DONE]收尾,最终数据块可能包含 finish_reason 和 usage。 - 如果连接直接关闭、没有
[DONE],或没有正常的 finish_reason,就应按中断处理。 - 站内端点文档说明,流式中途断开时最后一个用量块可能拿不到,但已经产生的 token 仍按实际生成量计费;断流后要新开请求,这个接口没有续传语义。
- 检查反向代理或网关的空闲超时、客户端是否逐行读取、是否错误地等待完整 JSON,以及是否把缓冲打开导致长时间看不到增量。
curl -N -i https://api.xisu.ai/v1/chat/completions \
  -H "Authorization: Bearer $XISU_API_KEY" \
  -H "Content-Type: application/json" \
  -d '{
    "model": "你的模型名",
    "messages": [{"role": "user", "content": "分三段回答:什么是 SSE?"}],
    "stream": true,
    "max_tokens": 128
  }'
Windows PowerShell:
curl.exe -N -i https://api.xisu.ai/v1/chat/completions `
  -H "Authorization: Bearer $env:XISU_API_KEY" `
  -H "Content-Type: application/json" `
  --data-raw '{
    "model": "你的模型名",
    "messages": [{"role": "user", "content": "分三段回答:什么是 SSE?"}],
    "stream": true,
    "max_tokens": 128
  }'
如果终端持续打印 data: 行并最终看到 [DONE],说明这次 OpenAI 兼容流大概率正常结束;如果只打印了一部分后连接关闭,应保存最后一行、状态头和 request_id。
import os
import json
import requests

url = "https://api.xisu.ai/v1/chat/completions"
headers = {
    "Authorization": f"Bearer {os.environ['XISU_API_KEY']}",
    "Content-Type": "application/json",
}
payload = {
    "model": "你的模型名",
    "messages": [{"role": "user", "content": "分三段回答:什么是 SSE?"}],
    "stream": True,
    "max_tokens": 128,
}

finished = False
with requests.post(url, headers=headers, json=payload, stream=True, timeout=(10, 120)) as response:
    response.raise_for_status()
    for raw in response.iter_lines(decode_unicode=True):
        if not raw or not raw.startswith("data:"):
            continue
        data = raw[5:].strip()
        if data == "[DONE]":
            finished = True
            break
        try:
            event = json.loads(data)
        except json.JSONDecodeError:
            print("无法解析事件:", data)
            continue
        choice = (event.get("choices") or [{}])[0]
        text = (choice.get("delta") or {}).get("content")
        if text:
            print(text, end="", flush=True)
        if choice.get("finish_reason") is not None:
            print(f"\nfinish_reason={choice['finish_reason']}")

print("stream_finished:", finished)
stream_finished: True 且出现 finish_reason,表示客户端读到了正常结束信号;如果为 False,不要把已显示的半截内容当作完整答案,应按一次中断请求记录并决定是否新开请求。
请求成功但账单对不上:按 request_id 逐笔核对
大白话:余额、调用明细和你自己统计的 token 可能不是同一个时间快照,也不一定采用同一种合计口径。先逐笔找 request_id,再比较输入、输出、缓存读取、缓存写入、费用、状态和数据截至时间。
- 到控制台调用明细按 request_id 查单笔请求。
- 核对时间、模型、密钥、输入 token、输出 token、缓存读取、缓存写入、耗时、费用和状态。
- 不要把“—”当成 0。站内账单文档说明,0 表示确实是零,— 表示没有拿到这个数或无法估算。
- 成功但费用为 0 可能是额度包抵扣、模型当前免费、本次无输出或系统判定不计费;失败请求也会显示在明细中,但不计费。
- 如果余额与用量不一致,比较两个页面各自的“数据截至”时间。刚调用完的请求可能还没有进入当前快照。
- 把重试次数算进去:一次业务操作可能产生多笔 API 请求,不能只按最终成功那一笔估算。
流式请求的用量可能在最后一个数据块中返回。站内端点文档明确说明,中途断开时最后用量块可能拿不到,但已经产生的 token 仍按实际生成量计费。因此不要用“客户端最终收到多少字符”直接反推计费 token。更多逐笔核对方法见 用量与账单怎么核对,计费口径见 计费口径。
模型列表为空或少了模型
大白话:模型列表通常是“这把密钥在这个地址下能看到什么”,不是所有平台或所有账号的完整模型目录。为空时先别急着修改客户端模型名称,先用 curl 确认接口返回。
先查什么
- 用 GET
/v1/models请求确认响应是否成功。 - 如果是 401,先处理密钥;站内说明密钥无效或余额为负时,模型列表接口也可能失败。
- 如果返回数组但数量少,检查密钥是否配置了模型范围限制,对应错误通常是
model_not_allowed。 - 检查客户端是否缓存了旧列表。修改 base_url、密钥或模型权限后,重启客户端并手动刷新模型列表。
- 检查 base_url 是否错误,尤其是把 OpenAI 官方地址遗留在客户端配置里,或把
/v1重复拼接。 - 如果使用 Claude Code,注意其 Anthropic base URL 不带
/v1;OpenAI 兼容 SDK 则通常需要包含/v1。
修好后,先在命令行看到目标模型 id,再把同一个 id 填回 SDK 或编码工具。Cursor 等支持自带 API Key 的工具也需要在模型设置中验证密钥;官方文档说明,验证后模型才会出现在模型选择器中,具体可用模型取决于供应商和工具支持范围。
Anthropic 原生协议:同样的 HTTP 状态,错误类型不同
大白话:/v1/messages 不是把 OpenAI Chat Completions 的 JSON 换个 URL,而是另一套请求、响应和错误类型。站内文档明确列出 Anthropic 原生错误:invalid_request_error 对应 400,authentication_error 对应 401,permission_error 对应 403,not_found_error 对应 404,request_too_large 对应 413,rate_limit_error 对应 429,api_error 对应 502 或 504,overloaded_error 对应 503。
Anthropic 官方错误文档也说明,错误响应包含顶层 error 对象、type、message 和 request_id。排查时不要把 OpenAI 兼容层的 invalid_api_key、rate_limit_exceeded 直接套到 /v1/messages 的 error.type 上。
invalid_request_error:看 message 修正载荷、输入长度、工具或内容格式,原样重试通常没有用。authentication_error:检查 x-api-key、密钥完整性、吊销状态和 IP 白名单。permission_error:看 message 判断是模型范围、内容策略还是账号状态。not_found_error:模型没有配 Anthropic 上游,换模型或改走 OpenAI 兼容端点。rate_limit_error:先看余额、配额和密钥预算,确认是限流后才退避。overloaded_error:临时没有可用上游,按 Retry-After 退避。
报障模板:让别人能复现,而不是猜测
报障前先去控制台请求日志按 request_id 查这一笔。不要提交完整 API Key、Cookie、Authorization 头或包含敏感业务数据的原始提示词;可以用脱敏后的最小载荷代替。
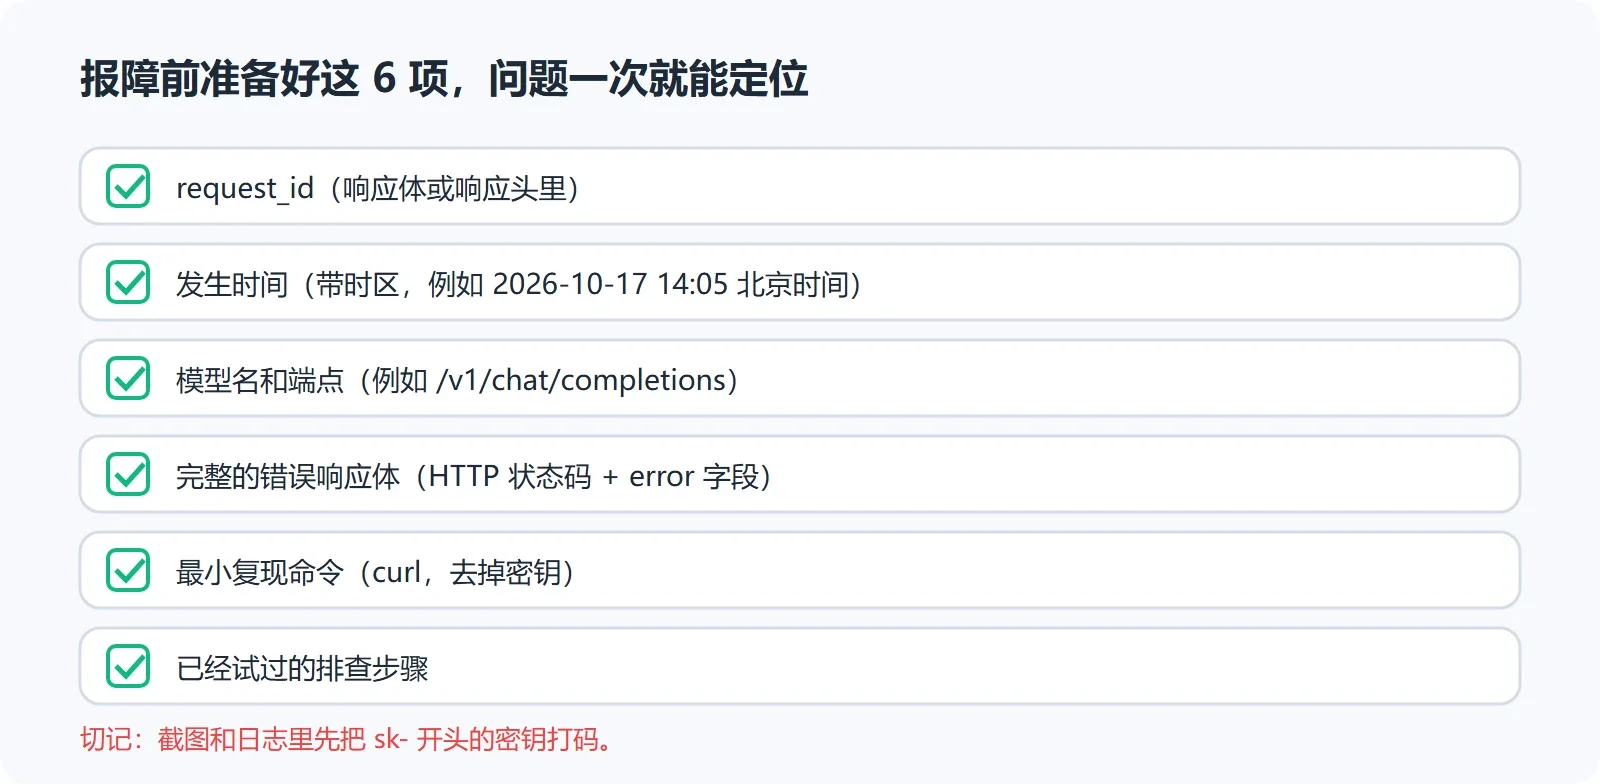
报障前准备好的 6 项信息
问题标题:API 返回 [HTTP 状态码] / [error code 或 error.type]

发生时间:2026-10-17 14:30:00(北京时间,UTC+8)
request_id:req_xxxx
模型:填写完整模型名
端点:POST https://api.xisu.ai/v1/chat/completions
协议:OpenAI 兼容 / Anthropic 原生

现象:
例如:请求返回 429,连续 3 次失败;或流式输出到一半连接关闭。

完整错误响应体(已去掉密钥和敏感内容):
{
  "error": {
    "code": "rate_limit_exceeded",
    "message": "这里粘贴完整 message"
  }
}

响应头中与排查有关的字段:
Retry-After: 填写实际值
request_id: req_xxxx

最小复现命令(已去掉密钥):
macOS/Linux:
curl -i -v https://api.xisu.ai/v1/chat/completions \
  -H "Authorization: Bearer sk-xxxx" \
  -H "Content-Type: application/json" \
  -d '{"model":"你的模型名","messages":[{"role":"user","content":"只回复 OK"}]}'

Windows PowerShell:
curl.exe -i -v https://api.xisu.ai/v1/chat/completions `
  -H "Authorization: Bearer sk-xxxx" `
  -H "Content-Type: application/json" `
  --data-raw '{"model":"你的模型名","messages":[{"role":"user","content":"只回复 OK"}]}'

已尝试:
1. 是否用 GET /v1/models 验证模型名:是/否
2. 是否换过一个模型对照:是/否
3. 是否查看余额和密钥预算:是/否
4. 是否按 Retry-After 等待后重试:是/否
5. 客户端、SDK、Node/Python 版本:填写版本
6. 是否经过反向代理或网关:是/否
一份好的报障材料至少包含 request_id、带时区的发生时间、模型、端点和完整错误响应体;如果能附最小复现命令,定位速度会更快。不要只写“API 报错了”或“账单不对”,这类描述无法对应到具体请求。
一套可复制的最终排查顺序
- 保存完整响应:状态码、响应头、错误体、request_id 和时间。
- 用 curl 最小请求确认 base_url、鉴权和端点。
- GET
/v1/models,确认密钥能看到目标模型。 - 把请求缩短到一个文本消息,先去掉工具、图片、长历史和复杂参数。
- 根据状态码决定动作:400/401/403/404/413 改配置或载荷;429/503 看 Retry-After 和账务;502/504 做模型对照并保存证据。
- 确认流式是否正常结束:OpenAI 兼容接口看
[DONE]和 finish_reason;Anthropic 原生接口按其事件流判断。 - 最后再回到 SDK、桌面客户端或编码工具,逐项恢复配置。每次只恢复一个变量,避免一次改动太多导致无法判断。
如果按本文仍然定位不到,先在控制台请求日志里按 request_id 查这一笔,再对照错误码与限流。从零接入则回到5 分钟接入,重新确认地址、密钥、模型和端点四项基础配置。
先按本文定位问题,通常可以把“API 不工作”拆成一个明确的配置项、一个载荷字段或一个暂时性状态;如果仍然查不出来,就带上 request_id 和最小复现材料到控制台继续核对。
常见问题
401 Unauthorized 和 invalid_api_key 是同一个问题吗?
不一定完全相同,但都应先按鉴权问题排查。检查密钥是否完整、环境变量是否生效、Authorization 头是否为 Bearer 加空格、Anthropic 协议是否使用 x-api-key,并确认密钥没有被吊销或受到 IP 白名单限制。
429 一直重试为什么还是失败?
因为 429 可能不是限流,也可能是余额不足、密钥预算到顶或配额用尽。先读 message 并检查余额和预算。只有明确属于请求过快时,才按 Retry-After 做指数退避加抖动;账务限制不会因为等待几秒自动消失。
模型列表为空,是接口坏了吗?
不一定。先用 GET /v1/models 检查响应状态。如果是 401,先修密钥;如果返回数组但缺少模型,检查 model_not_allowed、客户端缓存和 base_url;如果客户端仍连着官方地址,也会出现你以为“列表为空”或模型不一致的现象。
为什么模型名看起来正确,仍然 404?
可能是端点和协议不匹配。OpenAI 兼容请求通常使用 /v1/chat/completions,Anthropic 原生请求使用 /v1/messages。非 Claude 模型发到 Anthropic 端点可能返回 not_found_error;另外还要检查大小写、版本后缀以及地址是否重复拼接了 /v1。
工具 Schema 里 additionalProperties 一定要写 false 吗?
不是所有协议和模型都一概要求,但严格 Schema 或某些上游会要求对象结构明确。至少应补上根对象的 type,保证 required 中的字段都存在于 properties,并根据目标模型的官方工具调用规则处理 additionalProperties 和 strict。遇到错误时以 message 指出的具体字段为准。
流式输出看到一半断了,已经生成的内容算不算请求成功?
不要只用客户端是否显示过文字来判断。OpenAI 兼容流式通常检查最后的 [DONE] 和 finish_reason;没有正常结束信号就按中断处理。站内端点文档说明,中途断开时最后用量块可能拿不到,但已经产生的 token 仍按实际生成量计费;断流后应新开请求,这个接口没有续传语义。
把客户端 timeout 调到 10 分钟,就能解决 504 吗?
不一定。客户端 timeout 只能决定客户端愿意等多久,服务端或网关仍可能有硬截止时间。先减少输入、降低输出规模、使用流式并检查模型是否持续在相同时间点失败;如果 504 反复出现,保存 request_id 和耗时进行进一步排查。
请求失败但账单里有记录,是重复扣费吗?
失败请求可能出现在调用明细中,但站内账单文档说明失败请求不计费。成功但费用为 0 也可能是额度包抵扣、本次无输出、模型当前免费或系统判定不计费。请按 request_id、状态、费用说明和数据截至时间逐笔核对。
可以把完整 API Key 放进报障信息吗?
不可以。报障只使用 sk-xxxx、环境变量名称或脱敏后的前四位;Authorization、Cookie、完整请求中的密钥都应删除。完整密钥一旦出现在日志、截图、聊天记录或工单中,应按密钥泄露处理并及时更换。
参考资料
- 错误码与限流
- 端点与鉴权
- 工具的参数 schema 被拒
- 上线前:超时、重试与工具调用
- 用量与账单怎么核对
- 计费口径
- OpenAI API Error codes
- Anthropic Claude API errors
- Google Gemini API Troubleshooting guide
- Google Gemini API errors
- xAI Debugging Errors
- xAI Rate Limits
- Cursor API Keys
本文示例仅用于排查与开发测试;实际可用模型、协议能力、错误响应和计费结果以调用时的官方或平台页面为准。