模型与选型
如何确认调用到的是真模型?
问它是谁不算数。用分词器指纹、原厂功能和 request_id 逐笔对账来核对,附可直接运行的检测脚本。
用中转服务时,很多人都会担心:我付的是 A 模型的钱,拿到的会不会是更便宜的 B? 这一篇教你自己动手验证,不用相信任何人的保证(包括我们的)。
3 步快速核对
赶时间的话,按这三步做就够了:
- 跑检测脚本(约 5 分钟)。 复制下文「方法一」里的
check_model.py运行:GPT 看分词器的 5 段是否全部和 OpenAI 官方一致,Claude 看第二次请求是否命中提示词缓存。 - 抽一笔调用对账。 记下响应头里的
x-request-id和响应体里的usage,到控制台「调用明细」按请求编号搜出同一笔:模型和各项 token 应完全一致,费用按下文的公式能算回来。做法见下文「用 request_id、token 和费用核对每一笔」。 - 怀疑被换成小模型时,对照信号表复核。 见下文「怎么判断发生了模型替换或降级」。
全程都不需要问模型「你是谁」,它的回答不能当证据,原因下面会讲。
先说结论
| 方法 | 能看出什么 | 难度 |
|---|---|---|
| 跑下面的检测脚本(分词器 + 原厂功能) | 换了厂商:比如拿别家模型冒充 Claude 或 GPT | ⭐ 复制粘贴即可 |
| 拿同一组难题和官方并排对比 | 同厂降级:比如拿小模型冒充大模型 | ⭐⭐ 需要官方账号对照 |
| 用 request_id 对账(响应 usage ↔ 调用明细 ↔ 单价) | 记账对不上:记录的模型、token 数或费用和你实际拿到的不一致 | ⭐ 控制台里搜一下 |
| 问它「你是谁」、看文风 | 几乎什么都看不出 | 别用 |
为什么「问它是谁」不算数
模型对自己是谁的回答非常不可靠:
- 一句系统提示词就能让任何模型自称任何名字;
- 很多模型的训练数据里混着别家模型的对话,真模型也经常认错自己;
- 知识截止日期也一样,模型自己报的往往不准。
所以「它说自己是 Claude」既证明不了真,「它说自己是 GPT」也证明不了假。 要看的是它装不出来的东西。
方法一:5 分钟跑一个检测脚本(推荐)
第 1 步:准备
- 装 Python(3.8 或更新)。Windows 去 python.org 下载安装,安装时勾上 Add Python to PATH; macOS 和 Linux 一般自带。
- 打开终端(Windows 叫「命令提示符」或 PowerShell),运行:
pip install tiktoken
这是 OpenAI 官方的分词器,脚本拿它当「标准答案」。
准备三样东西,运行时脚本会依次问你。接入地址是这一串:
https://api.xisu.ai/v1- API Key:在控制台「API 密钥」里创建;
- 模型名:去模型广场点一下复制,不要手打。
第 2 步:保存脚本
把下面整段复制,保存成一个文件,名字叫 check_model.py(比如放在桌面):
#!/usr/bin/env python3
# 模型真伪自检。只用 Python 自带的库;检测 GPT 时需要先 pip install tiktoken。
import getpass
import json
import time
import urllib.error
import urllib.request
import uuid

# 中英混排、emoji、代码缩进、生僻字、数字 —— 各家分词器在这些地方差得最多。
# 逐段比对:别家分词器在某一段、甚至几段加起来的总数上和 OpenAI 碰巧相等并不稀奇,每一段都相等就不是巧合了。
SEGMENTS = [
    "鱻 龘 齉 —— 这是一段用来比对分词器的测试文本,量子纠缠。",
    "The quick brown fox jumps over the lazy dog, 1234567890 times.",
    "🙂🚀🧪 emoji 也算进来。🙂🚀🧪",
    "def tokenize(text):\n        return [ord(c) for c in text]    # 缩进与空格",
    "Pneumonoultramicroscopicsilicovolcanoconiosis, Ünïcödé, ½ ≈ 0.5",
]
SHORT_TEXT = "x"


def ask(prompt):
    value = ""
    while not value:
        value = input(prompt).strip()
    return value


def post(url, headers, body):
    try:
        req = urllib.request.Request(
            url,
            data=json.dumps(body).encode("utf-8"),
            headers={"content-type": "application/json", **headers},
            method="POST",
        )
        with urllib.request.urlopen(req, timeout=120) as resp:
            return resp.status, json.loads(resp.read().decode("utf-8"))
    except urllib.error.HTTPError as e:
        raw = e.read().decode("utf-8", "replace")
        try:
            return e.code, json.loads(raw)
        except ValueError:
            return e.code, {"raw": raw[:500]}
    except (urllib.error.URLError, TimeoutError, ValueError) as e:
        raise RuntimeError(f"连不上 {url}:{e}(检查接入地址是否抄对)")


def error_text(data):
    err = data.get("error")
    if isinstance(err, dict):
        return str(err.get("message", err))
    return str(err or data)[:300]


def load_tiktoken():
    try:
        import tiktoken
    except ImportError:
        print("  ⚠ 没装 tiktoken,无法和 OpenAI 分词器对照。先运行:pip install tiktoken")
        return None
    # GPT-4o 及之后的 OpenAI 模型都用 o200k_base。
    return tiktoken.get_encoding("o200k_base")


class Client:
    def __init__(self, base, key, model):
        self.base = base.rstrip("/")
        self.root = self.base[:-3] if self.base.endswith("/v1") else self.base
        self.key = key
        self.model = model

    def openai_chat(self, content, **extra):
        body = {"model": self.model, "messages": [{"role": "user", "content": content}]}
        body.update(extra)
        body.setdefault("max_tokens", 16)
        status, data = post(
            self.base + "/chat/completions", {"authorization": "Bearer " + self.key}, body
        )
        # 推理型模型不认 max_tokens,要 max_completion_tokens。
        if status == 400 and "max_completion_tokens" in error_text(data):
            body["max_completion_tokens"] = body.pop("max_tokens")
            status, data = post(
                self.base + "/chat/completions", {"authorization": "Bearer " + self.key}, body
            )
        return status, data

    def anthropic_messages(self, content, system=None):
        body = {
            "model": self.model,
            "max_tokens": 16,
            "messages": [{"role": "user", "content": content}],
        }
        if system is not None:
            body["system"] = system
        return post(
            self.root + "/v1/messages",
            {"x-api-key": self.key, "anthropic-version": "2023-06-01"},
            body,
        )

    def input_tokens(self, vendor, content):
        if vendor == "claude":
            status, data = self.anthropic_messages(content)
            field = ("usage", "input_tokens")
        else:
            status, data = self.openai_chat(content)
            field = ("usage", "prompt_tokens")
        if status != 200:
            raise RuntimeError(f"请求失败(HTTP {status}):{error_text(data)}")
        value = (data.get(field[0]) or {}).get(field[1])
        if not isinstance(value, int):
            raise RuntimeError(f"返回里没有 {field[0]}.{field[1]},无法比对")
        if vendor == "claude":
            # 输入较长时接口会自动走缓存,input_tokens 只算没命中缓存的部分,要把缓存的两项加回来。
            usage = data.get("usage") or {}
            value += (usage.get("cache_creation_input_tokens") or 0) + (usage.get("cache_read_input_tokens") or 0)
        return value


def official_claude_counts(official_key, model):
    def count(content):
        status, data = post(
            "https://api.anthropic.com/v1/messages/count_tokens",
            {"x-api-key": official_key, "anthropic-version": "2023-06-01"},
            {"model": model, "messages": [{"role": "user", "content": content}]},
        )
        if status != 200:
            raise RuntimeError(f"官方接口返回 HTTP {status}:{error_text(data)}")
        return data["input_tokens"]

    base = count(SHORT_TEXT)
    return [count(text) - base for text in SEGMENTS]


def test_tokenizer(client, vendor, results):
    print("\n【分词器指纹】")
    # 每段都和单个字母 "x" 相减,消息格式带来的固定开销会互相抵掉,剩下的就是这段文本本身的 token 数。
    base = client.input_tokens(vendor, SHORT_TEXT)
    diffs = [client.input_tokens(vendor, text) - base for text in SEGMENTS]
    print(f"  这家逐段的 token 数:{diffs}")
    if min(diffs) <= 0:
        results.append(("分词器", "可疑", f"有一段文本的 token 数竟不比单个字母多({diffs}),返回的计数不可信"))
        return

    enc = load_tiktoken()
    expected = None
    if enc is not None:
        expected = [len(enc.encode(text)) - len(enc.encode(SHORT_TEXT)) for text in SEGMENTS]
        print(f"  OpenAI 分词器逐段算出:{expected}")

    if vendor == "gpt":
        if expected is None:
            results.append(("分词器", "跳过", "没装 tiktoken"))
        elif diffs == expected:
            results.append(("分词器", "通过", f"{len(SEGMENTS)} 段全部与 OpenAI 官方分词器一致"))
        else:
            results.append(("分词器", "可疑", f"OpenAI 官方应为 {expected},这里是 {diffs}"))
        return

    if expected is not None and diffs == expected:
        results.append(("分词器", "可疑", "号称不是 GPT,逐段分词结果却与 OpenAI 完全一致"))
    elif expected is not None:
        differ = sum(1 for a, b in zip(diffs, expected) if a != b)
        results.append(("分词器", "通过", f"{len(SEGMENTS)} 段里有 {differ} 段与 OpenAI 不同,符合预期"))

    if vendor == "claude":
        official_key = getpass.getpass(
            "  有 Anthropic 官方 API Key 的话可以粘贴进来做精确对照(不显示,直接回车跳过):"
        ).strip()
        if official_key:
            try:
                official = official_claude_counts(official_key, client.model)
            except RuntimeError as e:
                print(f"  ⚠ {e}")
                return
            print(f"  Anthropic 官方逐段算出:{official}")
            if all(abs(a - b) <= 1 for a, b in zip(official, diffs)):
                results.append(("Claude 官方对照", "通过", "与 Anthropic 官方计数一致"))
            else:
                results.append(("Claude 官方对照", "可疑", f"官方为 {official},这里是 {diffs}"))


def test_logprobs(client, results):
    print("\n【逐 token 概率 logprobs】")
    status, data = client.openai_chat("用一句话介绍一下大熊猫。", logprobs=True, max_tokens=30)
    items = None
    if status == 200:
        items = (((data.get("choices") or [{}])[0].get("logprobs")) or {}).get("content")
    if not items:
        why = error_text(data) if status != 200 else "响应里没有 logprobs"
        print(f"  未拿到:{why}")
        results.append((
            "logprobs", "参考",
            "没拿到。推理型 GPT 官方本身就不支持;普通对话型 GPT 拿不到则可疑",
        ))
        return

    enc = load_tiktoken()
    if enc is None:
        results.append(("logprobs", "跳过", "没装 tiktoken"))
        return
    # 模型吐出的每一个 token 都必须是 OpenAI 词表里的一个完整词条。
    bad = 0
    for item in items:
        raw = bytes(item["bytes"]) if item.get("bytes") else item["token"].encode("utf-8")
        try:
            enc.encode_single_token(raw)
        except KeyError:
            bad += 1
    print(f"  共 {len(items)} 个 token,不在 OpenAI 词表里的:{bad} 个")
    if bad == 0:
        results.append(("logprobs", "通过", f"{len(items)} 个 token 全部在 OpenAI 词表里"))
    else:
        results.append(("logprobs", "可疑", f"有 {bad} 个 token 不在 OpenAI 词表里"))


def test_prompt_cache(client, results):
    print("\n【提示词缓存】")
    if input("  这一项会发两次各一万多 token 的请求(第二次大部分按缓存价计),费用约等于一次长对话。继续?[Y/n] ").strip().lower() == "n":
        results.append(("提示词缓存", "跳过", "已手动跳过"))
        return
    # 开头放一个随机串,保证第一次一定是"写入缓存"而不是碰上别人的缓存。
    lines = [f"Reference line {i:04d}: the quick brown fox jumps over the lazy dog." for i in range(500)]
    system = [{
        "type": "text",
        "text": f"[{uuid.uuid4()}]\n" + "\n".join(lines),
        "cache_control": {"type": "ephemeral"},
    }]
    rounds = []
    for n in (1, 2):
        start = time.time()
        status, data = client.anthropic_messages("只回复 OK。", system=system)
        elapsed = time.time() - start
        if status != 200:
            print(f"  第 {n} 次请求失败(HTTP {status}):{error_text(data)}")
            results.append(("提示词缓存", "跳过", "请求失败"))
            return
        usage = data.get("usage") or {}
        write = usage.get("cache_creation_input_tokens") or 0
        read = usage.get("cache_read_input_tokens") or 0
        print(f"  第 {n} 次:写入缓存 {write},读取缓存 {read},耗时 {elapsed:.1f} 秒")
        rounds.append((write, read))
        time.sleep(1)

    if rounds[1][1] > 0:
        results.append(("提示词缓存", "通过", f"第二次命中缓存 {rounds[1][1]} token"))
    else:
        results.append(("提示词缓存", "可疑", "两次都没命中缓存,原厂 Claude 应当命中"))


def main():
    print("模型真伪自检\n")
    base = ask("接入地址(文档里那一串,以 /v1 结尾):")
    key = getpass.getpass("API Key(输入时不显示,粘贴后回车):").strip()
    model = ask("要检测的模型名(从模型广场复制):")

    name = model.lower()
    if "claude" in name:
        vendor = "claude"
    elif "gpt" in name or name.startswith(("o1", "o3", "o4")):
        vendor = "gpt"
    else:
        vendor = "other"
    label = {"claude": "Claude", "gpt": "GPT", "other": "其它厂商"}[vendor]
    print(f"\n按「{label}」的方式检测。")

    client = Client(base, key, model)
    results = []
    try:
        test_tokenizer(client, vendor, results)
        if vendor == "gpt":
            test_logprobs(client, results)
        if vendor == "claude":
            test_prompt_cache(client, results)
    except RuntimeError as e:
        print(f"\n✖ {e}")
        return

    print("\n================ 结果 ================")
    marks = {"通过": "✅", "可疑": "❌", "参考": "ℹ️", "跳过": "⏭"}
    for item, verdict, note in results:
        print(f"{marks[verdict]} {item}:{verdict} —— {note}")
    if any(v == "可疑" for _, v, _ in results):
        print("\n有可疑项。建议换几个时间段重测;结果稳定的话,可以把这段输出发给服务商要解释。")
    else:
        print("\n没有发现可疑项。")


if __name__ == "__main__":
    main()
第 3 步:运行
在终端里进入文件所在的目录,运行:
python check_model.py
(macOS / Linux 上如果提示找不到 python,换成 python3。)
按提示粘贴接入地址、Key、模型名。Key 输入时屏幕上不会显示,粘贴后直接回车即可。 整个过程只发几次很短的请求;检测 Claude 时多一项会花掉大约一次长对话的费用,运行前会先问你。
第 4 步:看结果
最后会打印一张结果表,每一项是 ✅ 通过、❌ 可疑、ℹ️ 仅供参考或 ⏭ 跳过:
| 检测项 | 测的是哪类模型 | ✅ 的意思 | ❌ 的意思 |
|---|---|---|---|
| 分词器 | 所有模型 | GPT:token 数和 OpenAI 官方分词器分毫不差;其他模型:和 OpenAI 不一样(本来就该不一样) | GPT 对不上官方;或者号称不是 GPT,却和 OpenAI 分得一模一样 |
| logprobs | GPT | 模型吐出的每个 token 都在 OpenAI 的词表里 | 有 token 不在 OpenAI 词表里,说明背后不是 OpenAI 的模型 |
| 提示词缓存 | Claude | 第二次请求命中了缓存 | 两次都没命中,原厂 Claude 不会这样 |
出现 ❌ 先别急着下结论。 隔一段时间再跑两三次;结果稳定的话,把整段输出发给服务商,要一个解释。
原理:为什么这几项装不出来
不想看原理可以跳过这一节。
分词器是模型的「指纹」
模型不是按字读文本的,而是先把文本切成一个个 token,再按 token 计费。 每家用的切法(分词器)都不一样:同一段中英混排加 emoji 的文本, OpenAI 切出来是一个数,Claude 是另一个数,Gemini、DeepSeek、通义千问又各不相同。 即便是同一家,换一代模型也可能换分词器。
脚本的做法是:准备 5 段专挑难处的文本(生僻字、emoji、代码缩进、超长单词……),
每段单独发一次,再和只发一个字母 x 的请求相减。消息格式本身带来的固定开销每次都一样,相减就抵掉了,
剩下的就是那段文本的 token 数。之所以逐段比、不比总数:别家分词器在某一段、甚至几段加起来的总数上
和 OpenAI 碰巧相等并不稀奇,5 段全都相等就不是巧合了。
- GPT:OpenAI 的分词器是公开的(就是刚才装的 tiktoken),
GPT-4o 及之后的模型用的是
o200k_base,所以每一段都必须完全相等。 如果 OpenAI 将来给新模型换了分词器,这一项会对不上 —— 那时以 tiktoken 的官方说明为准。 - Claude:Anthropic 没有公开离线分词器,所以脚本只能确认它「不是 OpenAI 的切法」。
如果你有 Anthropic 官方的 API Key,脚本会顺便调用官方的计数接口(
count_tokens,免费), 得到精确的标准答案再比。⚠️ 拿来当裁判的必须是官方接口 —— 任何中转服务(包括我们)自己提供的计数接口都不能用来验证它自己。
这一项有一个前提:返回的 token 数要是模型实际报出的。 如果某个服务商的 token 数是自己估算出来的,这一项测到的就是它的估算器, 而不是模型 —— 但那本身也说明它的计费不是按真实用量来的,同样值得追问。
logprobs:每个 token 都要在词表里
OpenAI 的普通对话型模型可以返回「每个输出 token 的概率」(logprobs)。 真的 GPT 吐出的每一个 token,都必然是 OpenAI 词表里的一个词条; 换成别家模型,切出来的 token 对不上 OpenAI 的词表,很难伪造得滴水不漏。
推理型的 GPT 模型官方本身就不支持 logprobs,拿不到是正常的,脚本会标成「仅供参考」。
提示词缓存:Claude 的原厂功能
Claude 支持「提示词缓存」:同一段很长的前缀连续发两次,第二次会直接从缓存读取,
返回里的 cache_read_input_tokens 大于 0。脚本每次都在前缀开头放一个随机串,
保证第一次一定是新写入,第二次命中才算数。
走 OpenAI 兼容接口(
/v1/chat/completions)调 Claude 时,这类 Claude 专有的能力 不会生效 —— 那是两种协议之间转换造成的,不代表模型被换了。 脚本测 Claude 时自动走 Anthropic 原生接口/v1/messages,详见「Anthropic 原生端点」那一篇。
用 request_id、token 和费用核对每一笔
检测脚本回答的是「是不是这个模型」,这一节回答「这一笔记的账对不对」。要对上的有三样:响应里的 usage、控制台「调用明细」里的同一笔、按单价算出来的费用。
第 1 步:从响应里拿到 request_id 和 usage
每个对话响应都带响应头 x-request-id,它就是这一笔调用的编号;响应体里的 usage 是这一笔的 token 分项。先把密钥放进环境变量 XISU_API_KEY(PowerShell:$env:XISU_API_KEY="你的密钥";macOS / Linux:export XISU_API_KEY="你的密钥"),再运行下面的代码。
OpenAI 兼容接口,用官方 SDK(pip install openai):
import os
from openai import OpenAI

client = OpenAI(base_url="https://api.xisu.ai/v1", api_key=os.environ["XISU_API_KEY"])

raw = client.chat.completions.with_raw_response.create(
    model="gpt-6-luna",
    messages=[{"role": "user", "content": "用一句话介绍大熊猫。"}],
    max_tokens=50,
)
print("x-request-id:", raw.headers.get("x-request-id"))
print(raw.parse().usage)
Anthropic 原生接口 /v1/messages,只用 Python 自带的库:
import json, os, urllib.request

req = urllib.request.Request(
    "https://api.xisu.ai/v1/messages",
    data=json.dumps({
        "model": "claude-haiku-5-5",
        "max_tokens": 50,
        "messages": [{"role": "user", "content": "用一句话介绍大熊猫。"}],
    }).encode(),
    headers={
        "x-api-key": os.environ["XISU_API_KEY"],
        "anthropic-version": "2023-06-01",
        "content-type": "application/json",
    },
)
with urllib.request.urlopen(req) as resp:
    print("x-request-id:", resp.headers.get("x-request-id"))
    print(json.dumps(json.load(resp)["usage"], indent=2, ensure_ascii=False))
用 curl 的话加 -i,响应头会和响应体一起打印出来,找 x-request-id 那一行。注意响应体里的 id 字段是另一个东西,对账请用响应头里的编号。
usage 里的字段和「调用明细」的 Token 分项这样对应:
| 调用明细 | OpenAI 兼容接口的 usage |
Anthropic 原生接口的 usage |
|---|---|---|
| 输入 | prompt_tokens |
input_tokens + cache_read_input_tokens |
| 其中缓存命中 | prompt_tokens_details.cached_tokens |
cache_read_input_tokens |
| 缓存写入 | prompt_tokens_details.cache_write_tokens(有则看) |
cache_creation_input_tokens |
| 输出 | completion_tokens |
output_tokens |
| 其中推理 | completion_tokens_details.reasoning_tokens |
— |
两条「其中」已经包含在上一行里,不要重复相加;缓存写入不在「输入」里,单独一行。Anthropic 协议的 input_tokens 只算没命中缓存的那部分,所以对「输入」时要把 cache_read_input_tokens 加回去。
第 2 步:在「调用明细」里找到同一笔
打开控制台左侧的「调用明细」,在「请求编号」框里粘贴 request_id。每一行包括:时间和请求编号、模型和密钥前缀、Token 分项(输入 / 其中缓存命中 / 输出 / 其中推理 / 缓存写入 / 合计)、耗时、费用(积分)、状态。
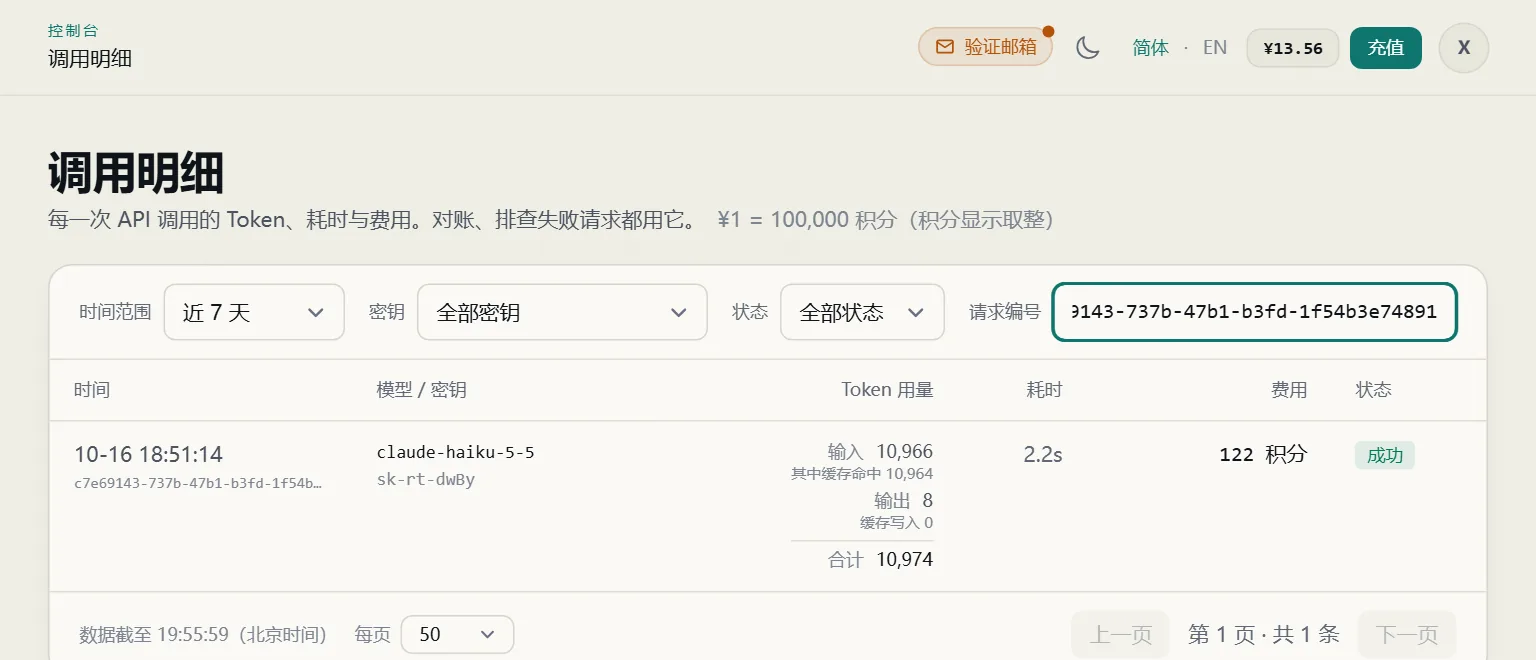
逐项对照:
- 模型:和你请求时写的
model一致; - 各项 token:和第 1 步拿到的
usage一致; - 状态:失败的请求也会列出来,费用显示「0 积分 本次无输出」,不计费。
几个容易误会的地方:
- 刚调用完可能还没进来。看页面上的「数据截至」时间,稍后刷新再搜。
- 明细只保留最近约 40 天,更早的查不到。
- Token 栏下方标着「估算值」的那一笔,token 数不是模型实际报出的准确值,不适合拿来做精确比对(检测脚本的分词器比对也一样)。
- 某一项显示「—」是没拿到这个数,「0」才是真的零。更多说明见 用量与账单怎么核对。
第 3 步:按单价把费用算回来
单价在 模型广场,单位是「积分 / 每 100 万 token」,分输入、输出、缓存读取、缓存写入几项。控制台的费用也用积分显示,¥1 = 100,000 积分。
费用(积分)= [(输入 − 其中缓存命中)× 输入单价
             + 其中缓存命中 × 缓存读取单价
             + 缓存写入 × 缓存写入单价
             + 输出 × 输出单价 ] ÷ 1,000,000
手算示例。 下面用的是示例单价,只为演示算法,不是任何模型的真实价格,真实单价以 模型广场 为准。
假设示例单价为:输入 200,000、缓存读取 20,000、输出 800,000(积分 / 每 100 万 token)。某一笔调用的明细是:输入 12,000(其中缓存命中 10,000),输出 500,没有缓存写入。
| 分项 | 计算 | 积分 |
|---|---|---|
| 没命中缓存的输入 | (12,000 − 10,000) × 200,000 ÷ 1,000,000 | 400 |
| 缓存命中 | 10,000 × 20,000 ÷ 1,000,000 | 200 |
| 输出 | 500 × 800,000 ÷ 1,000,000 | 400 |
| 合计 | 1,000 积分(= ¥0.01) |
核对时注意:
- 积分显示取整,手算结果和页面差 1 积分以内属正常;
- 「其中推理」已经算在输出里,不要再单独加一遍;
- 走额度包的那一笔费用列是 0,下方会写「额度包抵扣 … 积分」;
- 失败的请求不计费;流式输出中途断开,按已经生成的部分计费。
三样对不上时,开工单附上 request_id、响应里的 usage 原文和你的手算过程,我们按那一笔逐项解释。
方法二:抓「同厂降级」
分词器抓得住「换了厂商」,但抓不住「同一家里拿小模型冒充大模型」—— 它们的分词器往往是同一套。 这一类要比能力:
- 准备 10~20 道大小模型能拉开差距的题:多步推理、写一段较长的代码、 一条有很多细节要求的指令(比如「写 5 句话,每句恰好 12 个字,第 3 句以问号结尾」)。
- 同一组题,同时在官方和被测的服务上各跑 3 遍,比通过率。只比一两次没有意义,模型每次的输出本来就有波动。
- 顺便看速度:小模型通常明显更快。同样的问题,被测服务的出字速度如果比官方快很多,值得怀疑。
这一步需要你有官方账号做对照;没有的话,至少可以拿同一组题比较「便宜的小模型」和「贵的大模型」, 确认两者确实有差距 —— 如果花大价钱调的模型和小模型的表现完全一样,也是一个信号。
怎么判断发生了模型替换或降级
「被换模型」分两种:换了厂商(别家模型冒充 Claude 或 GPT),检测脚本能抓;同厂降级(同一家的小模型冒充大模型),分词器往往一样,只能靠上面的方法二比能力。下面把常见信号、可能原因和复核方法放在一张表里。单独一个信号不能下结论,至少换个时间段复测一次。
| 信号 | 可能原因 | 怎么复核 |
|---|---|---|
| GPT 的分词器有一段或几段对不上 OpenAI 官方 | 背后不是 OpenAI 的模型;也可能是 OpenAI 给新模型换了分词器 | 隔一段时间重跑 2~3 次;查 tiktoken 官方说明,确认这个模型用哪套编码 |
| 号称不是 GPT,5 段却和 OpenAI 分得一模一样 | 背后是 OpenAI 的模型 | 重跑;检测 Claude 时有 Anthropic 官方 Key 的话,用脚本里的官方 count_tokens 做精确对照 |
| 有一段文本的 token 数不比单个字母多,或计数明显不合理 | 返回的 token 数不是模型实际报出的,而是估算的 | 在「调用明细」里看这几笔是否标了「估算值」;换个时间段重跑 |
| 普通对话型 GPT 拿不到 logprobs,或有 token 不在 OpenAI 词表里 | 背后不是 OpenAI 的模型(推理型 GPT 官方本来就不给 logprobs,不算信号) | 先确认这个模型是不是推理型;再重跑 |
| Claude 两次请求都没命中提示词缓存 | 背后不是原厂 Claude;或者走的是 OpenAI 兼容接口(那条路上 Claude 专有功能不生效) | 确认请求走的是 /v1/messages(检测脚本会自动这样做);重跑 |
| 同一组难题的通过率明显低于官方同款模型 | 同厂小模型冒充大模型 | 按方法二:10~20 道题,同一时间在官方和被测服务各跑 3 遍,比通过率 |
| 同样的问题,出字速度比官方同款快很多 | 可能是更小的模型 | 同一时间段、同一组问题对比多次;单次快慢受网络和负载影响,不算数 |
| 贵的大模型和同厂便宜的小模型表现几乎一样 | 可能被换成了小模型 | 用同一组题对比两者,确认确实有差距 |
「调用明细」里的模型、token 和响应里的 usage 对不上 |
记账有误,或执行的模型和请求的不一致 | 按上一节用 request_id 找到那一笔,附 usage 原文开工单 |
| 「调用明细」模型名下方多了一行「实际执行 …」 | 这一笔由和请求名不同的模型执行 | 先确认请求里的 model 写的是什么;明确指定了模型却看到这一行,带 request_id 开工单 |
这张表里没有「问它是谁」,也没有「看响应里的 model 字段」:前者一句系统提示词就能改,后者服务端改一个字符串就能改,都不能当证据。
不靠谱的方法
下面这些经常被拿来「验货」,但都很容易伪造或误判,只能作为辅助:
- 问它是谁、问它的知识截止日期 —— 理由见上文;
- 看返回里的
model字段或 ID 前缀 —— 服务端改一个字符串就行; - 看文风(爱不爱用列表、爱不爱用 emoji)—— 同一个模型换个系统提示词,文风就完全不同;
- 「数 strawberry 里有几个 r」这类网传题 —— 各家新模型基本都已经答对,区分不了。
- 能不能调工具、能不能输出严格 JSON —— 这只能证明「有这个能力」,很多便宜的小模型也做得到,分不出是不是被换了。而且只在提示词里要求「只输出 JSON」测的是模型听不听话,测不到接口能力;真要测结构化输出,得用接口参数
response_format(json_schema+strict)。
在本站测试时
- 每一次调用都能在控制台「调用明细」里按请求编号(request_id)搜到,token 分项和费用可以和脚本、响应里的
usage对照,做法见上文。 - 检测时用的 Key 和正常调用是同一把,按正常价格计费;脚本的请求都很短,费用很低。
- 跑出 ❌ 的话,欢迎带着脚本输出开工单,我们会逐项给你解释。