实用文章
GPT、Claude、Gemini API 价格对比:100 万 token 到底多少钱?
本文从 token、输入输出计费、缓存读写和真实使用场景出发,对比 GPT、Claude、Gemini、Grok API 的每百万 token 成本,并提供聊天、长文本、代码助手、Agent 的费用估算、Python 与 JavaScript 成本计算器,以及可直接复制的 curl 调用示例,帮助你按实际用量选择 API 接入方式。
先给结论:100 万 token 不是固定价格,必须同时看输入、输出、缓存读取和缓存写入四项;同一个模型,聊天、长文本和 Agent 的实际费用可能相差一个数量级。按本文给出的本站价格与场景假设,普通聊天每次可能只花几厘到几分钱,但一次包含约 20 轮调用的 Agent 任务可能花费几角到数元。
如果你要把 API 接到自己的程序或编码工具,建议先按真实 token 用量估算,再比较模型单价,而不是只看“输入价”。先去模型价格表挑模型,再到控制台创建密钥,最后按5 分钟接入教程跑通第一次调用。
- 本文适用对象:第一次接触大模型 API 的开发者、需要给个人项目接入 API 的用户、正在配置代码助手或 Agent 的用户。
- 最后更新:2026-10-17。
- 实测或资料环境:本站价格数据截至 2026-10-17 16:35(北京时间);官方缓存机制、官方定价和订阅信息以 2026-10-17 查到的官方页面为准。
- 价格单位:除特别说明外,本文表格均使用人民币“元 / 每 100 万 token”;本站内部充值单位为积分,¥1 = 100,000 积分。
一、先弄懂 token:100 万 token 大约是多少字
大白话解释:token 是模型读写文本时使用的计量单位,可以理解为模型账单里的“字符片段”,但它不一定等于一个汉字、一个单词或一个字节。
中文大约多少字一个 token,只能写成经验值,因分词器不同而变。对于中文纯文本,100 万 token 换算成汉字,可以先按约 60 万至 150 万汉字做经验估算;代码、英文、数字、网址、JSON 和混合文本的比例越高,这个区间越不可靠。这里的换算只是经验估算,不应替代接口返回的 usage。
最可靠的做法有两种。第一种是实际调用后查看响应里的 usage 字段,分别记录输入 token、输出 token 和缓存 token。第二种是在支持该能力的接口上调用 /v1/messages/count_tokens,先对一段准备发送的消息进行计数,再决定是否截断、摘要或分批发送。
- 准备一段真实业务文本,不要只用“你好”测试,因为短文本的分词比例不能代表代码、长文或多轮对话。
- 发送请求并保存返回体中的 usage,同时保存 model、request_id 和时间。
- 把文字长度、token 数和实际费用放在一起比较,形成你自己的平均换算系数。
- 上线后继续以请求日志和控制台调用明细为准,不要用“字符数 × 一个固定比例”长期估算账单。
import os
from openai import OpenAI

client = OpenAI(
    api_key=os.environ.get("XISU_API_KEY", "sk-xxxx"),
    base_url="https://api.xisu.ai/v1",
)

response = client.chat.completions.create(
    model="gpt-6.1-sol",
    messages=[
        {"role": "user", "content": "请用三句话解释 token 是什么。"}
    ],
    max_tokens=200,
)

print(response.choices[0].message.content)
print(response.usage)
print("prompt_tokens:", response.usage.prompt_tokens)
print("completion_tokens:", response.usage.completion_tokens)
如果调用成功,你会看到模型回复和 usage 对象。重点记录 prompt_tokens、completion_tokens;如果模型或兼容层返回缓存字段,还要记录 cached_tokens 或 prompt_tokens_details.cached_tokens。
二、价格为什么要拆成四部分
大白话解释:一次请求不是只有“输入多少钱”,而是可能同时产生普通输入、缓存读取、缓存写入和输出四类 token 费用。
价格公式可以先记成:
费用 = 普通输入 token × 输入价 + 缓存读取 token × 缓存读价 + 缓存写入 token × 缓存写价 + 输出 token × 输出价
再除以 1,000,000,就得到按“每百万 token”报价时的实际金额。不同厂商对缓存的命名和生命周期并不完全相同,因此实际接入时应以对应模型的 usage 字段和官方定价页为准。
| 费用项 | 它代表什么 | 常见影响 |
|---|---|---|
| 输入 | 本次请求中没有从缓存复用的输入 token。 | 系统提示词、用户问题、历史对话、工具定义和文件内容都可能计入。 |
| 输出 | 模型新生成的 token。 | 输出单价通常明显高于输入单价,本文对比表中多数模型约为输入价的 3–6 倍。 |
| 缓存读取 | 本次请求命中已有缓存的输入 token。 | 重复上下文越多、缓存命中越稳定,节省越明显。 |
| 缓存写入 | 首次把可复用上下文写入缓存的 token。 | 首次请求可能比普通输入贵,之后的重复请求才使用缓存读取价。 |
不能只看输入价,主要有三个原因。第一,输出单价通常更高,长回答、代码生成和推理任务会放大输出成本。第二,Agent 会反复携带系统提示、工具说明、代码仓库摘要和历史状态,输入总量远大于普通聊天。第三,Agent 的重复上下文往往适合缓存,此时缓存读取价和缓存写入价会直接决定长期成本。
不同官方 API 的缓存方式也不同。OpenAI 的 Prompt Caching 主要围绕可复用的提示前缀,支持的模型会自动尝试复用相同前缀,并在 usage 中返回缓存 token,缓存部分按更低的单价计费,具体倍率随模型而变。
Anthropic 的 Prompt Caching 通常通过 cache_control 标记可缓存内容,并区分基础输入、缓存写入和缓存命中;官方定价页还区分 5 分钟和 1 小时缓存写入,缓存读取通常按照明显低于基础输入的价格计费。
Gemini 提供 implicit caching,也提供适用于部分接口和模型的显式 context caching。官方文档说明,缓存读取会在 usage metadata 中体现;显式缓存还可能涉及缓存 token 数量和存储时间,具体价格和支持范围要按模型页面确认。
以 OpenAI 官方文档为例,提示缓存通常要求请求拥有足够长且稳定的前缀,缓存读取和缓存写入的费率不是统一固定值;以 Gemini 官方文档为例,隐式缓存通常要求相似的前缀在较短时间内重复出现。对于 Anthropic,则需要在消息内容中明确设置缓存控制点。不要把一家厂商的缓存参数直接套到另一家厂商上。
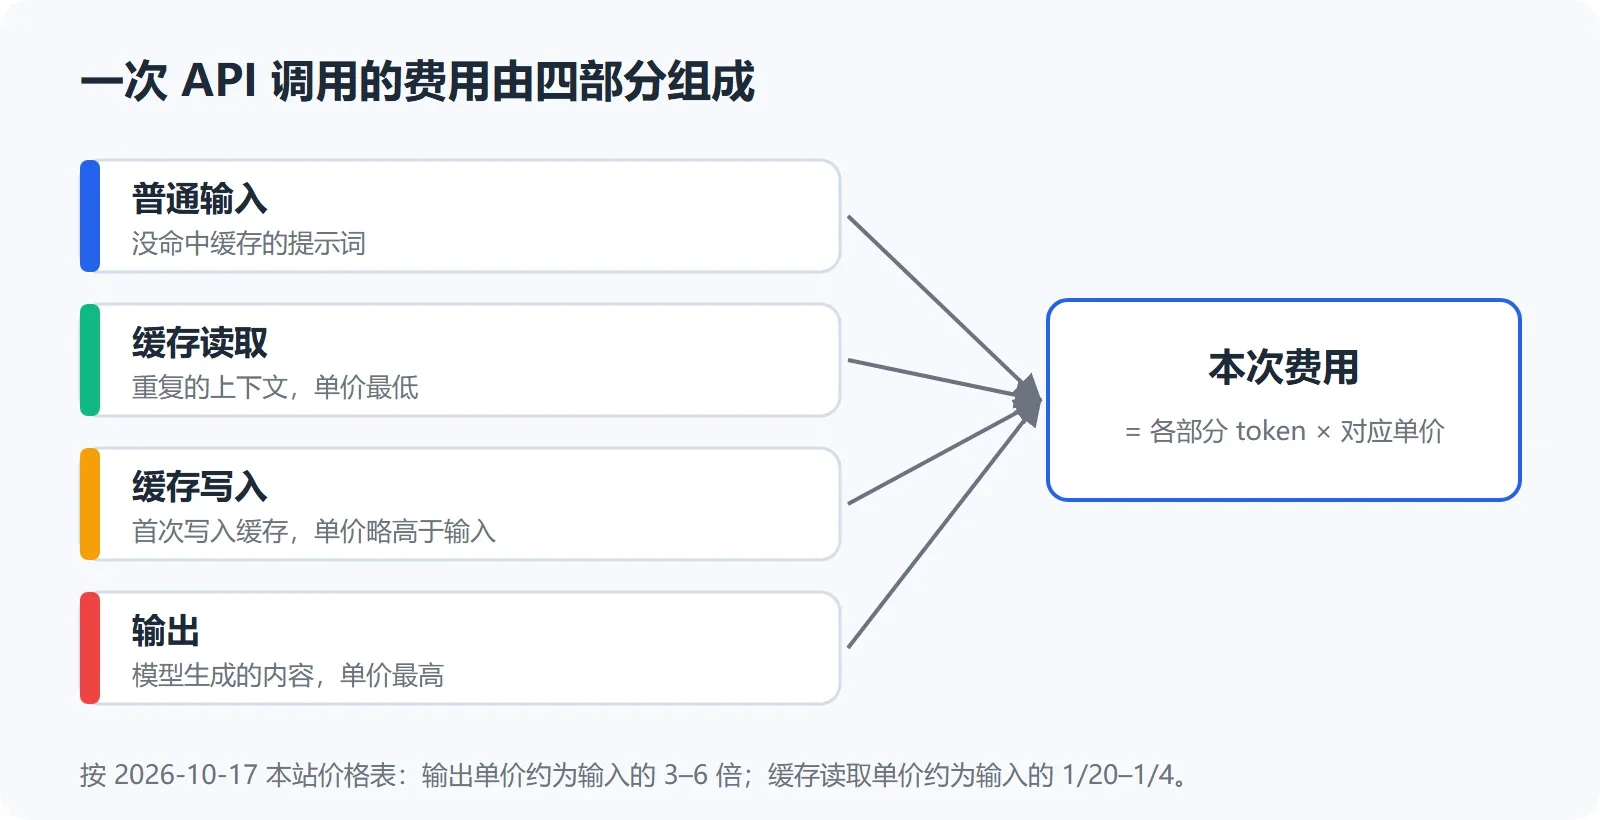
一次调用的费用 = 普通输入、缓存读取、缓存写入、输出四部分之和
怎么设计更容易命中缓存的请求
大白话解释:把长期不变的内容放在前面,把每次都变化的问题放在后面。
- 把稳定的系统提示词、角色说明、工具 schema、项目规则和仓库摘要放在前面。
- 把当前用户问题、时间戳、随机数、临时状态和本轮工具结果放在后面。
- 不要因为无关字段变化就重排整个提示词,否则可能破坏前缀匹配。
- 每次调用都保存 usage,确认缓存读写是否真的发生,而不是只凭请求结构猜测。
三、本站模型价格对比:先看每百万 token,再看场景
大白话解释:每百万 token 价格适合做横向比较,但真正选型还要把你的输入输出比例、缓存命中率和调用轮数代入。
价格数据截至 2026-10-17,本文每月更新一次。以下数据来自本站价格表,数据截至 2026-10-17 16:35(北京时间)。本站按实际用量计费,¥1 = 100,000 积分。表中“官方参考价”是用价格表上的折扣标示反推的美元价,汇率按页面使用的约 ¥7.2 = $1。按折扣标示推算,以各厂商官方定价页为准。
| 模型 | 本站折扣标示 | 输入 ¥ | 输出 ¥ | 缓存读取 ¥ | 缓存写入 ¥ | 官方参考价输入/输出 $ |
|---|---|---|---|---|---|---|
| claude-opus-5-5 | 3折 | 8.64 | 43.20 | 0.432 | 17.28 | 4.00 / 20.00 |
| claude-sonnet-5-5 | 3折 | 4.32 | 21.60 | 0.216 | 5.40 | 2.00 / 10.00 |
| claude-haiku-5-5 | 3折 | 1.08 | 5.40 | 0.108 | 2.16 | 0.50 / 2.50 |
| gpt-6.1-sol | 1折 | 1.44 | 7.20 | 0.072 | 1.80 | 2.00 / 10.00 |
| gpt-5.6-terra | 1折 | 1.44 | 8.64 | 0.144 | 1.80 | 2.00 / 12.00 |
| gpt-6-luna | 1折 | 0.072 | 0.36 | 0.0072 | 0.09 | 0.10 / 0.50 |
| gemini-4-argon-high | 1折 | 1.44 | 7.20 | 0.072 | 1.44 | 2.00 / 10.00 |
| gemini-3.8-flash-high | 1折 | 0.54 | 2.70 | 0.054 | 0.54 | 0.75 / 3.75 |
| grok-4.7 | 1折 | 1.44 | 4.32 | 0.36 | 1.44 | 2.00 / 6.00 |
需要特别说明:表中“官方参考价”只是按本站折扣标示反推出来的参考值,不是厂商报价。OpenAI、Anthropic、Google、xAI 的官方定价页通常还会按上下文长度、批处理、服务档位或地区区分价格,并且会调整;正式比较前,请打开文末参考资料里的官方定价页,用当天的数字核对。完整 19 个模型请以模型价格表实时状态为准;当前是否可调用也以价格表页面为准,本文不写“全部可用”。
此外,生图模型 gpt-image-2.5 系列按张计费,每张 4,500 积分,约 ¥0.045。图片价格不能直接和文本模型的每百万 token 单价混在一起比较。
四、四个真实使用场景:100 万 token 到底会花多少钱
大白话解释:同一个模型在不同任务里的成本,取决于输入多少、输出多少,以及重复上下文是否命中缓存。
以下数字直接采用本文设定的场景假设:
- 普通聊天:一次输入 2,000 token,输出 500 token,无缓存。
- 长文本总结:一次输入 50,000 token,输出 2,000 token。
- 代码助手一轮:输入 30,000 token,其中 25,000 token 命中缓存读取,输出 2,000 token。
- Agent 一次任务:约 20 轮,累计输入 600,000 token,其中 30,000 token 缓存写入、500,000 token 缓存读取、70,000 token 普通输入,输出 30,000 token。
| 模型 | 聊天 | 长文本 | 代码一轮 | Agent 一次任务 |
|---|---|---|---|---|
| claude-opus-5-5 | 0.0389 | 0.5184 | 0.1404(0.3456) | 2.6352(6.4800) |
| claude-sonnet-5-5 | 0.0194 | 0.2592 | 0.0702(0.1728) | 1.2204(3.2400) |
| claude-haiku-5-5 | 0.0049 | 0.0648 | 0.0189(0.0432) | 0.3564(0.8100) |
| gpt-6.1-sol | 0.0065 | 0.0864 | 0.0234(0.0576) | 0.4068(1.0800) |
| gpt-5.6-terra | 0.0072 | 0.0893 | 0.0281(0.0605) | 0.4860(1.1232) |
| gpt-6-luna | 0.0003 | 0.0043 | 0.0013(0.0029) | 0.0221(0.0540) |
| gemini-4-argon-high | 0.0065 | 0.0864 | 0.0234(0.0576) | 0.3960(1.0800) |
| gemini-3.8-flash-high | 0.0024 | 0.0324 | 0.0095(0.0216) | 0.1620(0.4050) |
| grok-4.7 | 0.0050 | 0.0806 | 0.0248(0.0518) | 0.4536(0.9936) |
表中代码助手和 Agent 的括号内数字,是不走缓存时的费用。它们不是“额外收费”,而是用同样的 token 数全部按普通输入价计算后的对照值,用来帮助你判断缓存是否值得设计。
对于 Claude Code,站内教程记录的经验是:首次请求会写入约 3 万 token 缓存,缓存约 5 分钟有效。具体请求仍应以响应 usage 和控制台请求日志为准,不要把这条经验值当成所有客户端、所有会话都固定如此。
两个按月估算的例子:
- 每天 50 次聊天使用 gpt-6.1-sol,一个月按 30 天计算:50 × 30 × 0.0065 = 9.75 元。
- 每天 5 个 Agent 任务使用 claude-sonnet-5-5,一个月按 30 天计算:5 × 30 × 1.2204 = 183.06 元。
这些是场景假设,不是账单承诺。真实 token 以响应 usage 和控制台请求日志为准。控制台调用明细会记录模型、密钥、输入、输出、缓存读取等分项,以及费用、状态和 request_id;对账时不要只看一个总 token 数。可以参考用量与账单怎么核对。
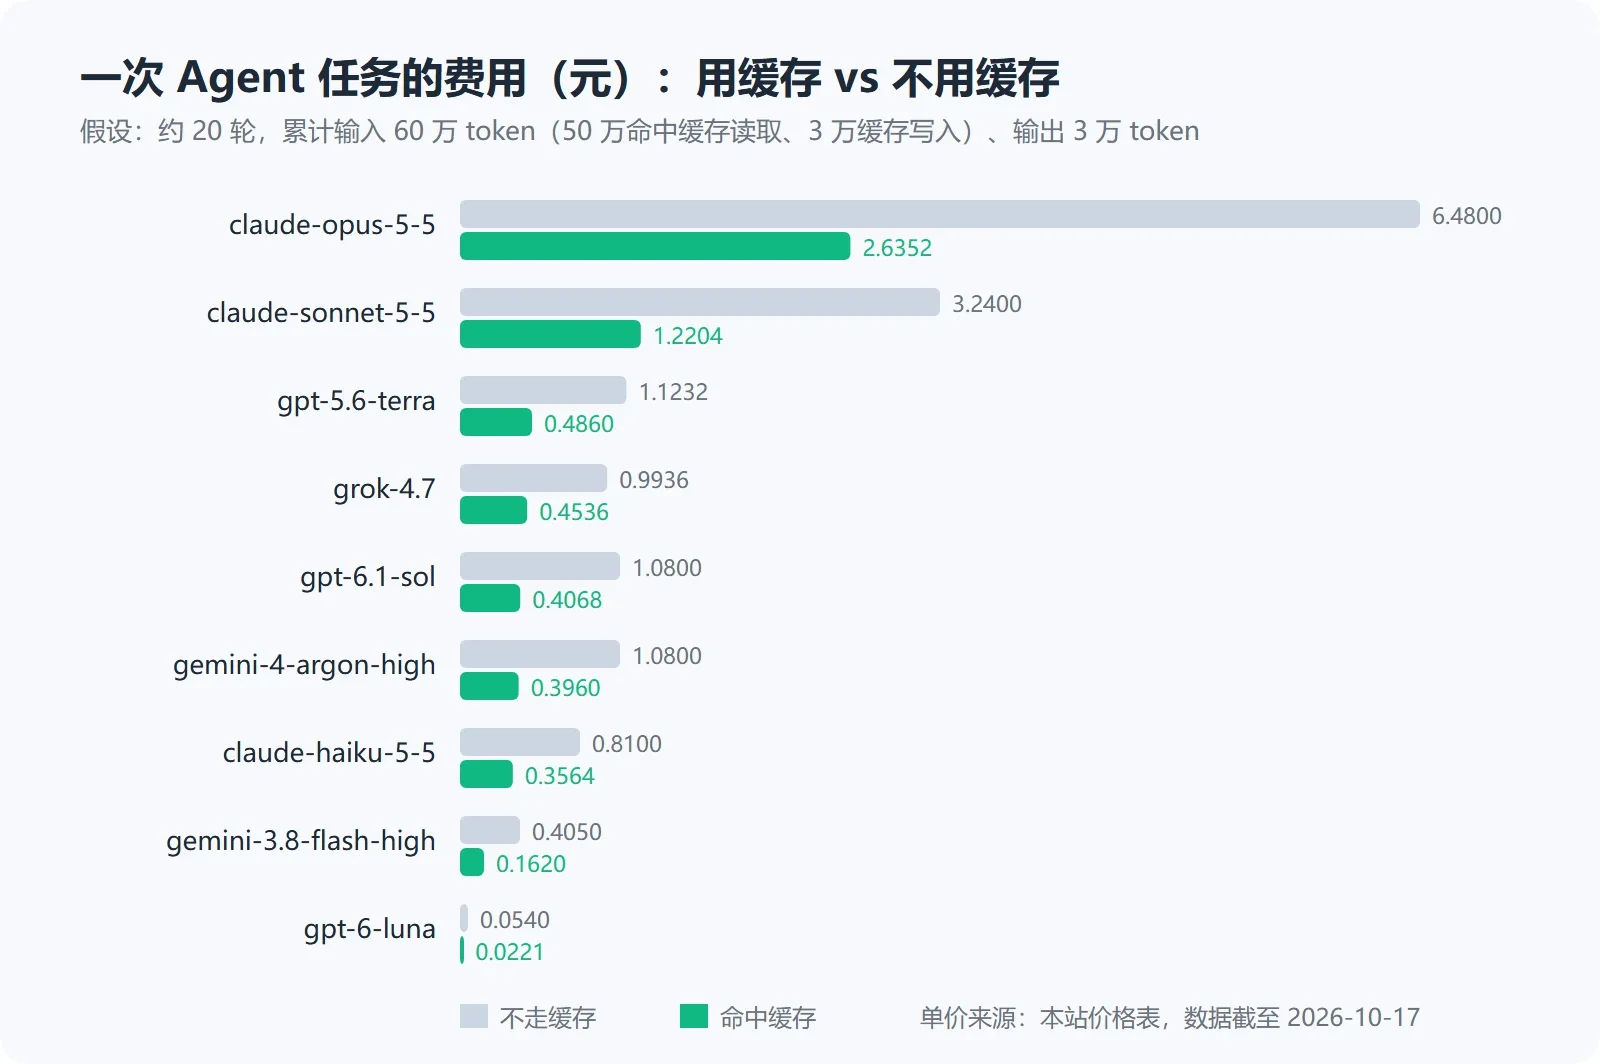
同一个 Agent 任务,命中缓存与不走缓存的费用对比(本站价格,数据截至 2026-10-17)
五、官方 API、订阅制和第三方 API,怎么选
大白话解释:订阅制买的是某个产品里的使用额度或功能,官方 API 按接口用量计费,第三方 API 通常把多个模型放到统一入口,适合希望少改代码、集中充值和统一核对的人。
| 方式 | 怎么收费 | 适合谁 | 能否用于自己的程序或编码工具 | 通常需要什么支付方式 |
|---|---|---|---|---|
| 官方 API | 按模型、输入输出 token、缓存、批处理或服务档位计费,具体以厂商官方定价页为准。 | 需要直接使用官方控制面、官方能力或企业级 API 管理的团队。 | 可以,通常需要申请官方 API 账号、密钥和支付配置。 | 以对应厂商支持的信用卡、账单账户、预付费或企业结算方式为准。 |
| 订阅制 | 按月或按年支付,通常附带消息量、模型、工具或编码产品的使用限制。 | 主要在网页、桌面端、移动端或官方编码产品中使用的个人用户。 | 一般不能直接等同于 API 余额;例如 Anthropic 明确说明 Claude Pro 不包含 Console API 用量,OpenAI 也明确说明 ChatGPT Plus 与 API 用量分开计费。 | 以产品页面和所在地区支持的支付方式为准。 |
| 第三方 API | 可能按实际 token 用量、模型单价、缓存分项和账户余额结算。 | 需要统一 base_url、同时测试多个模型,或希望使用本地支付方式的个人开发者。 | 通常可以,前提是客户端支持兼容协议或允许自定义 base_url。 | 以平台实际支持方式为准;本站支持支付宝和微信。 |
订阅价格会随地区、产品档位和时间变化,本文不列具体数字,购买前请以 ChatGPT、Claude、Google AI 各自官方页面为准。需要记住的只有一点:订阅额度和 API 用量是两套账,订阅不能当作 API 余额使用。
如果你选择第三方 API,建议至少核对下面六点:
- 是否按 token 实际计费,而不是按“调用次数”粗略扣费。
- 输入、输出、缓存读取和缓存写入是否分开显示。
- 计费精度是否足够高,低单价模型是否会因四舍五入造成误差。
- 请求日志能否通过 request_id 逐笔核对。
- 余额是否过期,失败请求、流式中断和无输出请求如何计费。
- 是否能验证实际调到的是真模型,而不是只看客户端里填写的模型名称。可参考如何确认调用到的是真模型。
本站计费口径是按实际用量计费,精度到小数点后 10 位;积分不过期,¥1 = 100,000 积分,最低充值 ¥10,支持支付宝和微信,调用后结算不预扣。失败请求不计费;流式响应中途断开时,已经生成的部分照常计费。
六、成本计算器:把 usage 直接换算成金额
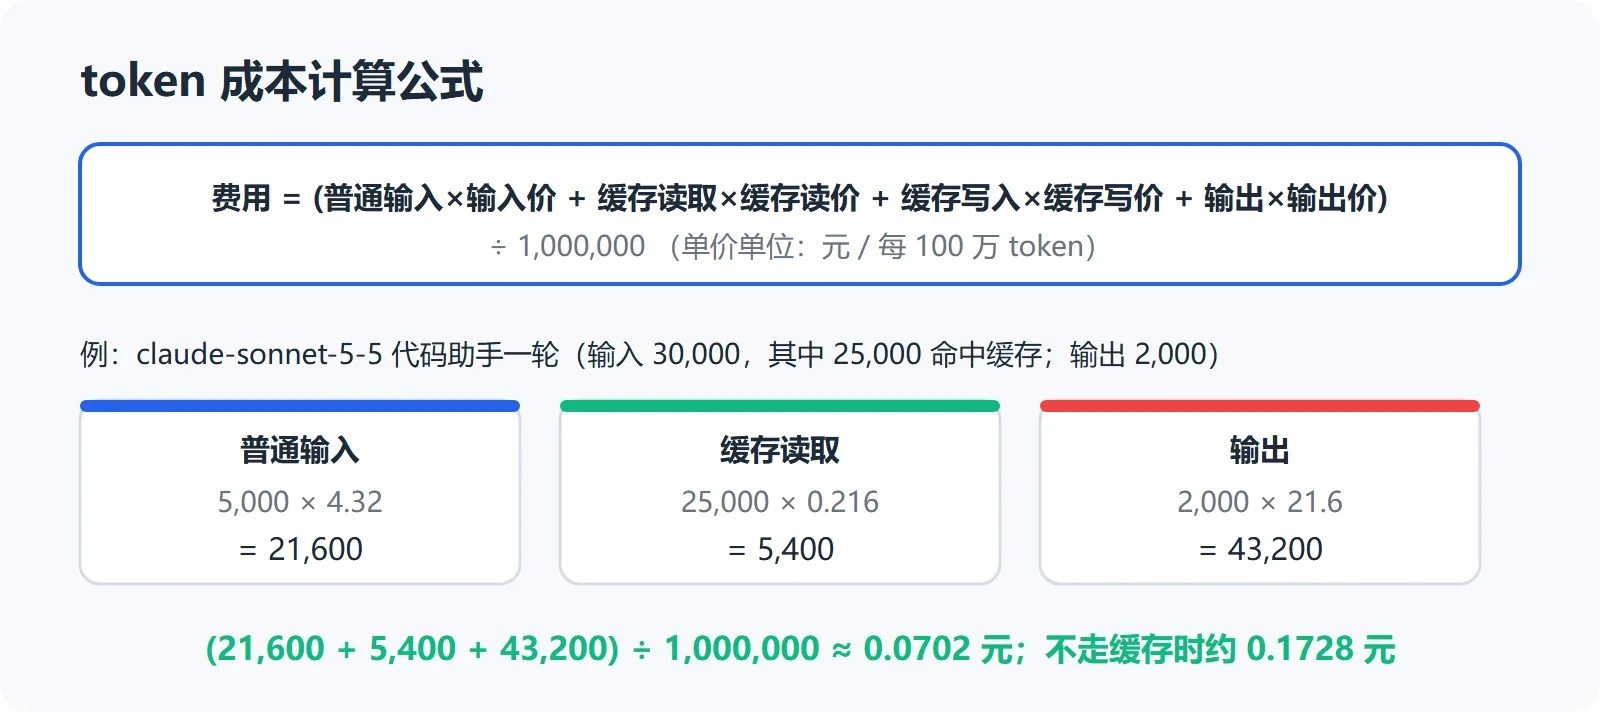
成本计算公式与 claude-sonnet-5-5 代码助手一轮的算例
大白话解释:成本计算器不负责猜 token,它只负责把你已经拿到的 token 分项和单价代入公式。
费用 = (普通输入×输入价 + 缓存读取×缓存读价 + 缓存写入×缓存写价 + 输出×输出价) ÷ 1,000,000
下面的 Python 函数内置 4 个模型的单价,单位是“元 / 每百万 token”。你可以把价格替换成价格表中的实时数值。
PRICES = {
    "gpt-6.1-sol": {"input": 1.44, "output": 7.20, "cache_read": 0.072, "cache_write": 1.80},
    "gpt-6-luna": {"input": 0.072, "output": 0.36, "cache_read": 0.0072, "cache_write": 0.09},
    "gemini-3.8-flash-high": {"input": 0.54, "output": 2.70, "cache_read": 0.054, "cache_write": 0.54},
    "claude-sonnet-5-5": {"input": 4.32, "output": 21.60, "cache_read": 0.216, "cache_write": 5.40},
}

def estimate_cost(model, normal_input, cache_read, cache_write, output):
    p = PRICES[model]
    total = (
        normal_input * p["input"]
        + cache_read * p["cache_read"]
        + cache_write * p["cache_write"]
        + output * p["output"]
    ) / 1_000_000
    return round(total, 10)

print(estimate_cost("gpt-6.1-sol", 2000, 0, 0, 500))
print(estimate_cost("claude-sonnet-5-5", 70000, 500000, 30000, 30000))
第一行会得到约 0.0065 元,第二行会得到约 1.2204 元。若结果与表格有极小差异,通常是显示位数或四舍五入造成的。
下面是可直接在浏览器控制台运行的 JavaScript 版本:
const prices = {
  "gpt-6.1-sol": { input: 1.44, output: 7.20, cacheRead: 0.072, cacheWrite: 1.80 },
  "gpt-6-luna": { input: 0.072, output: 0.36, cacheRead: 0.0072, cacheWrite: 0.09 },
  "gemini-3.8-flash-high": { input: 0.54, output: 2.70, cacheRead: 0.054, cacheWrite: 0.54 },
  "claude-sonnet-5-5": { input: 4.32, output: 21.60, cacheRead: 0.216, cacheWrite: 5.40 }
};

function estimateCost(model, normalInput, cacheRead, cacheWrite, output) {
  const p = prices[model];
  const total = (
    normalInput * p.input +
    cacheRead * p.cacheRead +
    cacheWrite * p.cacheWrite +
    output * p.output
  ) / 1000000;
  return Number(total.toFixed(10));
}

console.log(estimateCost("gpt-6.1-sol", 2000, 0, 0, 500));
console.log(estimateCost("claude-sonnet-5-5", 70000, 500000, 30000, 30000));
浏览器控制台会输出两个数字,分别对应普通聊天和带缓存的 Agent 任务。实际项目中可以把 prices 替换成后端配置,避免价格变化时重新发布前端代码。
用 curl 发起第一次 Chat Completions 调用
macOS/Linux:
export XISU_API_KEY="sk-xxxx"
curl https://api.xisu.ai/v1/chat/completions \
  -H "Content-Type: application/json" \
  -H "Authorization: Bearer $XISU_API_KEY" \
  -d '{
    "model": "gpt-6.1-sol",
    "messages": [
      {"role": "user", "content": "请用一句话解释 token。"}
    ],
    "max_tokens": 100
  }'
Windows PowerShell:
$env:XISU_API_KEY = "sk-xxxx"
$body = @{
  model = "gpt-6.1-sol"
  messages = @(
    @{ role = "user"; content = "请用一句话解释 token。" }
  )
  max_tokens = 100
} | ConvertTo-Json -Depth 5

Invoke-RestMethod `
  -Uri "https://api.xisu.ai/v1/chat/completions" `
  -Method Post `
  -Headers @{ Authorization = "Bearer $env:XISU_API_KEY" } `
  -ContentType "application/json" `
  -Body $body
返回体里通常先看 choices[].message.content 是否有模型文本,再看 usage。兼容 OpenAI Chat Completions 的返回一般包含 prompt_tokens 和 completion_tokens;如果有缓存,可能在 prompt_tokens_details.cached_tokens 或兼容层提供的 cached_tokens 字段中出现。不同模型和端点的字段可能不同,缺少某个字段时不要自行补成 0,应以实际返回为准。
curl https://api.xisu.ai/v1/chat/completions \
  -H "Content-Type: application/json" \
  -H "Authorization: Bearer sk-xxxx" \
  -d '{"model":"gpt-6.1-sol","messages":[{"role":"user","content":"测试 usage"}],"max_tokens":50}'
命令输出是 JSON。把 prompt_tokens 视为普通输入和缓存输入的总输入量时,必须再根据返回的缓存分项拆开;completion_tokens 对应输出 token。若返回体没有缓存字段,先按无缓存估算,并在控制台调用明细中用 request_id 核对。
七、六条可执行的省钱建议
大白话解释:省钱不是单纯换成低价模型,而是减少不必要的 token、让重复内容命中缓存,并让每一轮 Agent 都有明确边界。
- 简单任务选小模型。分类、改写、提取字段、格式转换和短问答可以先用低价模型;只有在准确性、复杂推理或代码质量不够时,再切换更高档模型。
- 控制 max_tokens。max_tokens 不是一定会全部扣费,但它会给模型更大的输出空间。对固定格式的任务,设置合理上限并要求简洁输出,通常更容易控制账单。注意:本站 GPT 系列目前 max_tokens 这类输出上限参数没有生效,输出可能超过上限并按实际输出计费(见低价 API 中转怎么辨别第 7 节);修复前,GPT 模型请先在提示词里要求简短输出。Claude 系列正常。
- 固定系统提示词前缀。把角色、规则、工具 schema 和项目约束放在固定前缀,动态问题放在后面,有助于提高缓存命中机会。OpenAI 官方文档强调稳定的 prompt prefix,Gemini 官方文档也建议把大段公共内容放在前面并在较短时间内重复使用。
- 长文先摘要。不要在每一轮都把完整文档、全部历史对话和所有工具结果重新发送。可以先生成结构化摘要,再让后续请求携带摘要和当前相关片段。
- 限制 Agent 轮数。给任务设置最大轮数、最大总 token、最大工具调用数和超时。一个“直到完成为止”的循环,很容易把输入和输出成本同时放大。
- 按 request_id 核对账单。每天或每周抽样对比响应 usage、客户端日志和控制台调用明细。遇到余额差额时,带上时间范围、模型、request_id 和完整错误响应体,而不是只说“账单不对”。
八、从价格表到第一次调用的操作清单
如果你是第一次接 API,可以按下面顺序操作:
- 先明确任务类型:普通聊天、长文总结、代码助手还是多轮 Agent。
- 记录一次真实请求的输入长度、预期输出长度、是否会重复发送相同上下文。
- 到模型价格表查看输入、输出、缓存读写价格,并确认页面显示的当前可调用状态。
- 用本文公式或成本计算器计算单次费用,再乘以每天调用次数和每月天数。
- 注册后充值,本站最低充值 ¥10,积分不过期,支持支付宝和微信。
- 到控制台创建密钥。密钥明文只显示一次,创建时立即保存到密码管理器或环境变量中。
- 把客户端的 base_url 指向
https://api.xisu.ai/v1,使用XISU_API_KEY环境变量保存密钥。 - 完成第一次调用后,保存 response usage、模型名称和 request_id,再到控制台调用明细核对费用。
如果你的客户端不是 OpenAI SDK,也可以查看OpenAI 兼容接口说明;如果使用 Anthropic 原生消息格式,可以查看Anthropic Messages 接入说明。不同端点的返回字段和参数支持范围可能不同,先确认端点,再复制示例。
常见问题
100 万 token 到底是多少钱?
没有统一答案。输入和输出价格不同,缓存读取和缓存写入价格也不同。按照本文本站价格表,gpt-6-luna 的普通输入每百万 token 为 0.072 元、输出为 0.36 元,而 claude-opus-5-5 的普通输入为 8.64 元、输出为 43.20 元。真实费用还要看你的输入输出比例和缓存命中情况。
中文 100 万 token 是不是 100 万个汉字?
不是。中文大约多少字一个 token,只能写成经验值,因分词器不同而变。可以先把 100 万 token 粗略估成约 60 万至 150 万汉字,但代码、数字、英文、JSON 和混合文本会明显改变结果。最可靠的方法是查看响应 usage,或调用支持的 /v1/messages/count_tokens 计数接口。
为什么输出价通常比输入价高?
输出是模型逐步生成的新 token,很多模型的输出单价高于输入单价。本文价格表中的多数模型,输出单价约为输入单价的 3–6 倍,所以长回答、代码生成、推理结果和 Agent 的最终输出都需要单独估算。
缓存读取和缓存写入有什么区别?
缓存写入是第一次把可复用上下文放进缓存,缓存读取是后续请求复用已经存在的上下文。写入可能比普通输入贵,读取通常更低价,但缓存生命周期、最小 token 数、匹配规则和 usage 字段由各厂商和模型决定。
ChatGPT Plus 或 Claude Pro 能直接抵扣 API 费用吗?
通常不能直接这样理解。OpenAI 官方帮助页说明 ChatGPT Plus 的订阅与 API 用量分开;Anthropic 官方帮助页也说明 Claude Pro 不包含 Console API 用量。订阅主要用于对应产品里的功能和额度,自己的程序通常需要单独配置 API 账号与计费。
第三方 API 会不会按月固定收费?
本站按实际用量计费,没有月租和最低消费,但需要先充值余额;调用结束才结算,不预扣。失败请求不计费,流式中断时已经生成的部分照常计费。具体账单以控制台调用明细和页面上的数据截至时间为准。
为什么响应里只有 prompt_tokens,没有 cached_tokens?
不同模型、端点和兼容层返回字段可能不同。先查看完整 JSON,再查看控制台调用明细中的输入、输出和缓存读取分项。如果页面显示“—”,它表示没有拿到这个数,不等于真实数值为 0;对账时可以通过 request_id 提交工单。
怎么确认调用到的是真模型?
不要只看客户端填写的 model 字符串。可以按照模型验证教程发送指定测试请求,结合返回的模型信息、特征输出和控制台日志交叉确认。模型名称、别名和当前可调用状态都可能变化,最终以实时页面和实际响应为准。
生图模型也按 token 计费吗?
本文提到的 gpt-image-2.5 系列按张计费,每张 4,500 积分,约 ¥0.045。图片尺寸、质量、模型版本和页面规则可能变化,使用前应查看价格表的当前说明。
密钥可以直接写进前端 JavaScript 吗?
不建议。浏览器代码、移动端安装包和公开仓库都可能暴露密钥。开发环境使用 XISU_API_KEY 环境变量,生产环境把请求放在自己的后端,并限制密钥权限、定期轮换和检查请求日志。可以参考密钥安全说明。
参考资料
- 模型价格表 / 模型广场
- 5 分钟接入
- OpenAI 兼容接口
- 用量与账单怎么核对
- 如何确认调用到的是真模型
- OpenAI Prompt Caching
- OpenAI API Pricing
- Anthropic Claude Pricing
- Anthropic Pricing
- Gemini Developer API Pricing
- Gemini Context Caching
- xAI API Pricing
- ChatGPT Pricing
- What is the Claude Pro plan?
- Google One Plans
如果你已经知道自己的任务类型,下一步就不用继续猜:先去模型价格表挑模型,再到控制台创建密钥,按5 分钟接入跑通第一次调用,然后用真实 usage 和 request_id 校准你的月度预算。
本文价格、模型名称、缓存规则和可调用状态可能随官方页面及平台实时配置变化;正式使用前请以相关官方定价页、模型页面和控制台实际账单为准。