实用文章
低价 API 中转怎么辨别?5 个常见风险和验真方法
数据安全、偷换模型、倍率虚标、用量虚标、账号稳定性:每个风险给出怎么测、怎么判,最后用同一套标准自评犀速AI。
先说明: 低价不一定不可靠。价格差异可能来自官方折扣、缓存、批量采购或供应商策略。本文不评价任何具体服务商,只给可以复现的检查方法;判断以接口响应、账单记录、隐私政策和稳定性数据为准,不以价格高低或任何一方的说法为准,包括我们自己的。
本文怎么用:下面 5 个风险,每个都给出怎么测和怎么判,最后汇总成一张判断表。测试一律用虚构内容,不要把真实客户资料、API Key 或源代码发给任何中转做测试,包括我们。
1. 数据安全:「一块钱一百万 token,你以为捡了便宜,其实数据在裸奔」
你发给中转的每一条请求,都会先经过它的服务器。价格再低,也要先弄清它怎么处理这些内容。
怎么测:看政策里写没写这 5 件事。
| 要问的 | 看什么 |
|---|---|
| 是否保存请求和回复正文 | 默认存不存;存的话存什么、谁能看 |
| 留存多久 | 调用记录、正文、日志各留多久,有没有具体天数 |
| 人工能否接触 | 客服或运维在什么条件下能看到内容,有没有审计 |
| 能否删除 | 能不能申请删除,注销账号后怎么处理 |
| 是否用于训练或出售 | 有没有明确写「不用于训练、不出售」 |
然后用一段虚构文本把流程走一遍:
XISU_SECURITY_TEST_2026_001
客户姓名:测试用户甲(虚构)
订单号:TEST-0000-0001(虚构)
- 用这段文本发一次请求,记下响应头里的 request_id;
- 看控制台的调用记录里会不会显示这段正文;
- 问客服:能不能看到这一笔的内容?保存多久?能不能删除?
- 把看到的、听到的和政策逐条对照。
怎么判: 没有隐私政策,或者政策只有「我们重视您的隐私」而没有范围和天数,按高风险处理。控制台或客服能把正文原样给出来,而政策写的是「不保存」,说明做法和政策不一致,也是高风险。
反过来要记住:发了没泄露,不能证明安全。 你看不到服务端发生了什么。真正能依靠的只有两样:写清楚的政策,以及出了问题能不能按政策追责,也就是有没有明确的运营主体、联系渠道和留痕的工单记录。
2. 偷换模型:「付旗舰的钱,后台跑乞丐版」
先排除几种常见但不可靠的方法,它们最多算弱信号:
- 问它「你是谁」:一句系统提示词就能改,真模型也经常认错自己;
- 看响应里的
model字段:服务端改一个字符串就行; - 测工具调用、严格 JSON:只能证明「有这个能力」,便宜模型也做得到。真要测结构化输出,要用 API 参数
response_format的json_schema(strict: true),而不是在提示词里要求输出 JSON。
怎么测:三步。
- 分词器指纹。 同一段文本,不同厂商的分词器算出的
prompt_tokens不同。用验真文章里的检测脚本跑一遍,GPT 应当和 OpenAI 官方分词器逐段一致。这一步抓的是「换了厂商」。 - 同厂比能力。 同一家的大小模型往往共用分词器,第 1 步抓不到。准备 10~20 道能拉开差距的题,在官方和被测服务上同时各跑 3 遍,比通过率。
- request_id 对账。 每一笔在控制台查到的模型和 token 分项,要和响应里的
usage一致。
怎么判: 分词器多次复测都对不上,是高风险;三步都通过,模型身份可以算「已验证」;只做了第 1 步,只能排除换厂商。完整脚本、原理和替换信号表见 如何确认调用到的是真模型?。
3. 倍率虚标:「单价看着低,账单比官方还狠」
要点:
- 只认「每 100 万 token 多少钱」,并且按输入、输出、缓存读取、缓存写入四项分别比。「X 折」「倍率」「分组系数」都要换算回这个单位再比。
- 算清充值换算。 如果充进去的是「额度」「美元」「点数」,先算清 1 元到底能买多少。
- 别只看输入价。 输出通常比输入贵好几倍,只比输入价会严重低估账单。
- 留意按次收费、最低消费、充值手续费这类不在单价里的费用。
最小核对: 拿一笔真实调用,用它的 usage 乘以平台公开的单价算一遍,和实际扣费比;再用同样的 usage 乘以官方单价算一遍。前一个应当对得上,后一个才是真正「便宜了多少」。
怎么判: 四项单价公开、手算和扣费对得上,是已验证;只公布倍率、换算后对得上,是部分可信;算不出单价或手算对不上,是高风险。逐项核对方法见 低价 API 中转的账单和用量怎么核对?。
4. 用量虚标:「调一千,扣两三千」
要点:
- token 数不能按字数换算。 各家分词器不同,「这段 1000 字」不等于 1000 token。
- 输入看一致,输出看上限。
temperature=0也不保证每次输出一样,所以别拿输出长短比;但同一个请求连发几次,prompt_tokens应当完全一致,completion_tokens不应超过你设的max_tokens(推理模型的推理 token 也算在completion_tokens里,同样受这个上限约束)。 - 关掉 SDK 的自动重试(
max_retries=0)。否则一次调用失败后被悄悄重发,可能扣了几次钱你都不知道。 - 流式请求要加
stream_options={"include_usage": true},否则拿不到usage,也就没法对账。
最小核对: 关掉自动重试,选一个模型(下面以 claude-haiku-5-5 为例),让它写一段长回答,例如「详细介绍大熊猫,至少 300 字」,max_tokens 设 50,同一个请求发 3 次,记下 3 个 request_id 和各自的 usage。应当看到:prompt_tokens 三次相同;completion_tokens 不超过 50,被上限截断时 finish_reason 是 length。然后到控制台查:应当正好 3 笔,每笔的 token 分项和 usage 一致。
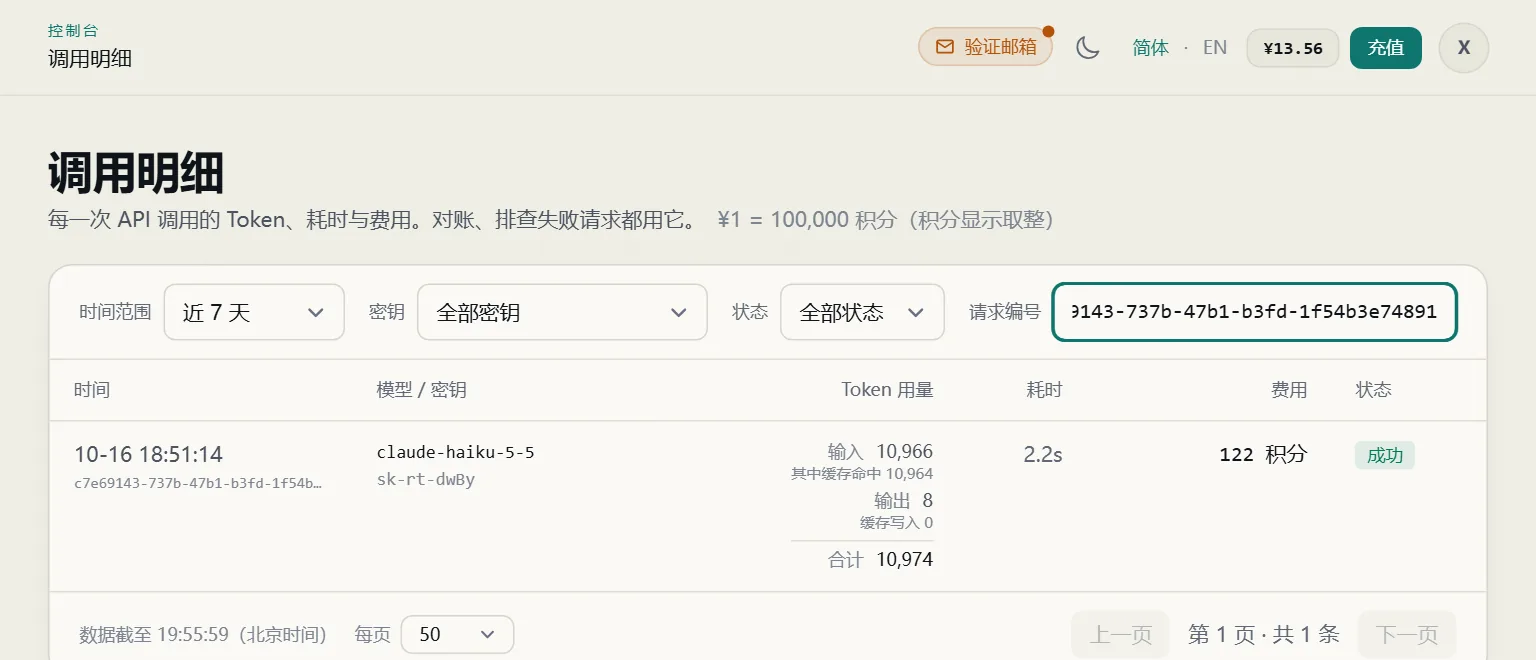
怎么判: 条数和 token 都对得上,是已验证;平台只给汇总账单、没有逐笔明细,最多算部分可信;条数多出来、记录的 token 比 usage 大,或者同样的输入每次 prompt_tokens 都不同,是高风险。completion_tokens 超过 max_tokens 时,要么上限参数没有生效,要么计数有问题,两种情况你都在为超出的部分付费,应当要求服务商解释。详细步骤和脚本同样见 低价 API 中转的账单和用量怎么核对?。
5. 账号来路与稳定性:「半夜说封就封,智能体中断」
这一项靠提示词测不出来。服务商背后用什么账号、风控状态如何,都在服务端,你在请求里看不到。能看的是运营证据:
| 看什么 | 为什么重要 |
|---|---|
| 公开状态页 | 能不能随时查到当前是否可用 |
| 故障与维护记录 | 出过什么问题、多久恢复、有没有提前通知 |
| 多密钥 | 能不能按业务分开,一把出问题不拖垮全部 |
| 余额预警 | 余额快用完时会不会提前提醒,而不是直接断 |
| 退款规则 | 平台原因导致不可用时怎么退,写没写清楚 |
| 封禁或停服后的处理 | 余额怎么处理、通过什么渠道通知你 |
怎么测: 先用低金额、低风险的任务连续跑 3~7 天,白天和夜间都要覆盖,记下失败率、超时次数和错误码;中途开一张工单,看看客服多久回复。
怎么判: 有状态页和历史故障记录、试跑没有异常,是已验证;试跑正常但没有公开状态页或故障记录,只能算部分可信;试跑中频繁中断,或者停服、封禁都没有说明,是高风险。
生产环境怎么防: 无论用哪家,都要保留备用服务,关键智能体不要只绑一个中转。代码里至少做三件事:设超时、给重试设上限、主线路不行时切到备用 base_url。下面是一段可以直接运行的 Python(pip install openai):
import os
import time

from openai import OpenAI, APIConnectionError, APIStatusError

# 主线路在前,备用线路在后;地址、密钥、模型名都从环境变量读。
PROVIDERS = [
    {"base_url": os.environ.get("PRIMARY_BASE_URL", "https://api.xisu.ai/v1"),
     "key_env": "PRIMARY_API_KEY", "model": os.environ.get("PRIMARY_MODEL", "gpt-6-luna")},
    {"base_url": os.environ.get("BACKUP_BASE_URL", ""),
     "key_env": "BACKUP_API_KEY", "model": os.environ.get("BACKUP_MODEL", "")},
]
RETRY_SAME = {429, 500, 502, 503, 504}  # 这些状态值得在同一条线路上再试一次


def chat(messages, tries_per_provider=2):
    errors = []
    for p in PROVIDERS:
        key = os.environ.get(p["key_env"])
        if not (p["base_url"] and key and p["model"]):
            continue  # 没配置的线路直接跳过
        client = OpenAI(base_url=p["base_url"], api_key=key,
                        timeout=30,      # 单次请求最多等 30 秒
                        max_retries=0)   # 关掉 SDK 自带重试,次数由下面说了算
        for attempt in range(tries_per_provider):
            try:
                resp = client.chat.completions.create(
                    model=p["model"], messages=messages, max_tokens=200)
                return p["base_url"], resp
            except APIConnectionError as e:          # 连不上、超时
                errors.append(f"{p['base_url']}: {type(e).__name__}")
            except APIStatusError as e:
                errors.append(f"{p['base_url']}: HTTP {e.status_code}")
                if e.status_code == 400:
                    raise                            # 请求本身有错,换线路也没用
                if e.status_code not in RETRY_SAME:
                    break                            # 401/403 等:不重试,直接换下一条线路
            time.sleep(2 ** attempt)                 # 退避 1 秒、2 秒
    raise RuntimeError("所有线路都失败了:" + "; ".join(errors))


if __name__ == "__main__":
    used, resp = chat([{"role": "user", "content": "只回复 OK"}])
    print("线路:", used)
    print("request_id:", resp._request_id)
    print("usage:", resp.usage.prompt_tokens, resp.usage.completion_tokens)
运行前设置环境变量 PRIMARY_API_KEY;配了 BACKUP_BASE_URL、BACKUP_API_KEY 和 BACKUP_MODEL 才会启用备用线路,没配就跳过。不同的错误分开处理:
- 400:请求本身有错,换线路也没用,直接抛出;
- 401 / 403:这条线路的密钥或账号有问题,不重试,直接换下一条;
- 429 / 5xx、连接失败或超时:同一条线路退避后再试一次,还不行再换。
超时的那次请求可能已经在服务端执行并计费,所以重试次数一定要有上限。备用线路的模型名可能不一样,单独配置。
6. 最终判断表
| 项目 | 已验证 | 部分可信 | 高风险 |
|---|---|---|---|
| 模型身份 | 分词器指纹通过,同厂比能力没有明显差距,request_id 对账一致 | 只跑了分词器,或者没有官方账号对照 | 分词器多次复测都对不上,或贵模型表现和同厂小模型一样 |
| 价格 | 四项单价公开,手算和扣费一致 | 只给倍率或折扣,换算后对得上 | 算不出单价,或手算对不上 |
| 用量 | 逐笔明细和 usage 一致,条数一致,输出不超过上限 |
只有汇总账单;或输出超过 max_tokens,但逐笔记录和 usage 一致 |
条数或 token 多于 usage,相同输入 prompt_tokens 不同 |
| 数据安全 | 政策写明存储范围、天数、人工接触条件、删除方式和不训练,实际表现与政策一致 | 有政策,但缺天数或范围 | 没有政策,或实际表现和政策矛盾 |
| 稳定性 | 有状态页和历史故障记录,试跑 3~7 天无异常 | 试跑正常,但没有公开状态页或故障记录 | 试跑中频繁中断,停服或封禁没有说明 |
7. 用同样的标准看犀速AI
我们的价格同样低于官方,模型广场上部分模型标注为官方价 1–3 折,所以欢迎你用本文的方法来测我们。下面是如实的自评:
| 检查项 | 犀速AI 目前的情况 | 在哪里看 |
|---|---|---|
| 隐私政策与留存期限 | 有。 默认不保存请求和回复正文;调用明细保留 40 天,之后只留按天汇总;登录记录 30 天;工单在最后一次回复后 30 天删除;不用于训练、不出售;可以通过工单申请注销账号,注销后删除账号信息。请求需要转发给上游模型供应商,这一段按其各自的数据政策处理 | 隐私政策 |
| 人工接触内容 | 只有你在工单里同意后,才会对相关密钥临时开启内容采样:最长 24 小时,加密保存,3 天后删除,开启和查看都有审计 | 隐私政策 |
| 逐笔对账 | 有。 每笔都有 request_id(响应头 x-request-id)、Token 分项、耗时、费用和状态;失败请求不计费 |
用量与账单怎么核对 |
| 单价公开 | 有。 每个模型公开输入、输出、缓存读取、缓存写入四项单价;按量计费,调用结束才结算,不预扣 | 模型广场 |
| 输出上限参数 | 目前有已知问题。 2026-10-16 实测:GPT 系列的 max_tokens、max_completion_tokens、max_output_tokens 没有生效,输出可能超过你设的上限,并按实际输出计费;Claude 系列正常。修复之前,请不要依赖这个参数控制 GPT 模型的费用 |
— |
| 模型掺假退款 | 有。 提供证据、经核实后退还受影响的费用 | 充值与退款 |
| 密钥控制 | 有。 IP 白名单、模型范围、单密钥预算、轮换(有宽限期)、吊销,可以建多把密钥 | 数据安全与密钥安全说明 |
| 余额提醒 | 有。 余额低于 10 元时,控制台会收到通知,并发邮件到已验证的注册邮箱;余额用完、新请求被拒绝时也会提醒。同一种提醒 24 小时内最多发一次 | 充值与退款 |
| 维护与变更通知 | 有。 官方公告页 | 官方公告 |
| 客服渠道 | 站内工单、Telegram @xisuai_support | — |
| 公开状态页 | 目前没有 | — |
| 公开历史故障记录 | 目前没有 | — |
| SLA | 目前没有 | — |
| 上游来源 | 不公开上游账号和供应来源 | — |
按第 6 节的标准,「稳定性」这一项我们目前最多只能算部分可信,需要你自己试跑来判断;「用量」这一项逐笔对账能对上,但在 GPT 输出上限的问题修复之前,也只能算部分可信。建议先买 10 元测试(见 充值与退款),用低风险任务跑几天,再决定要不要放进生产环境。关键业务保留备用服务,这一条对我们同样适用。